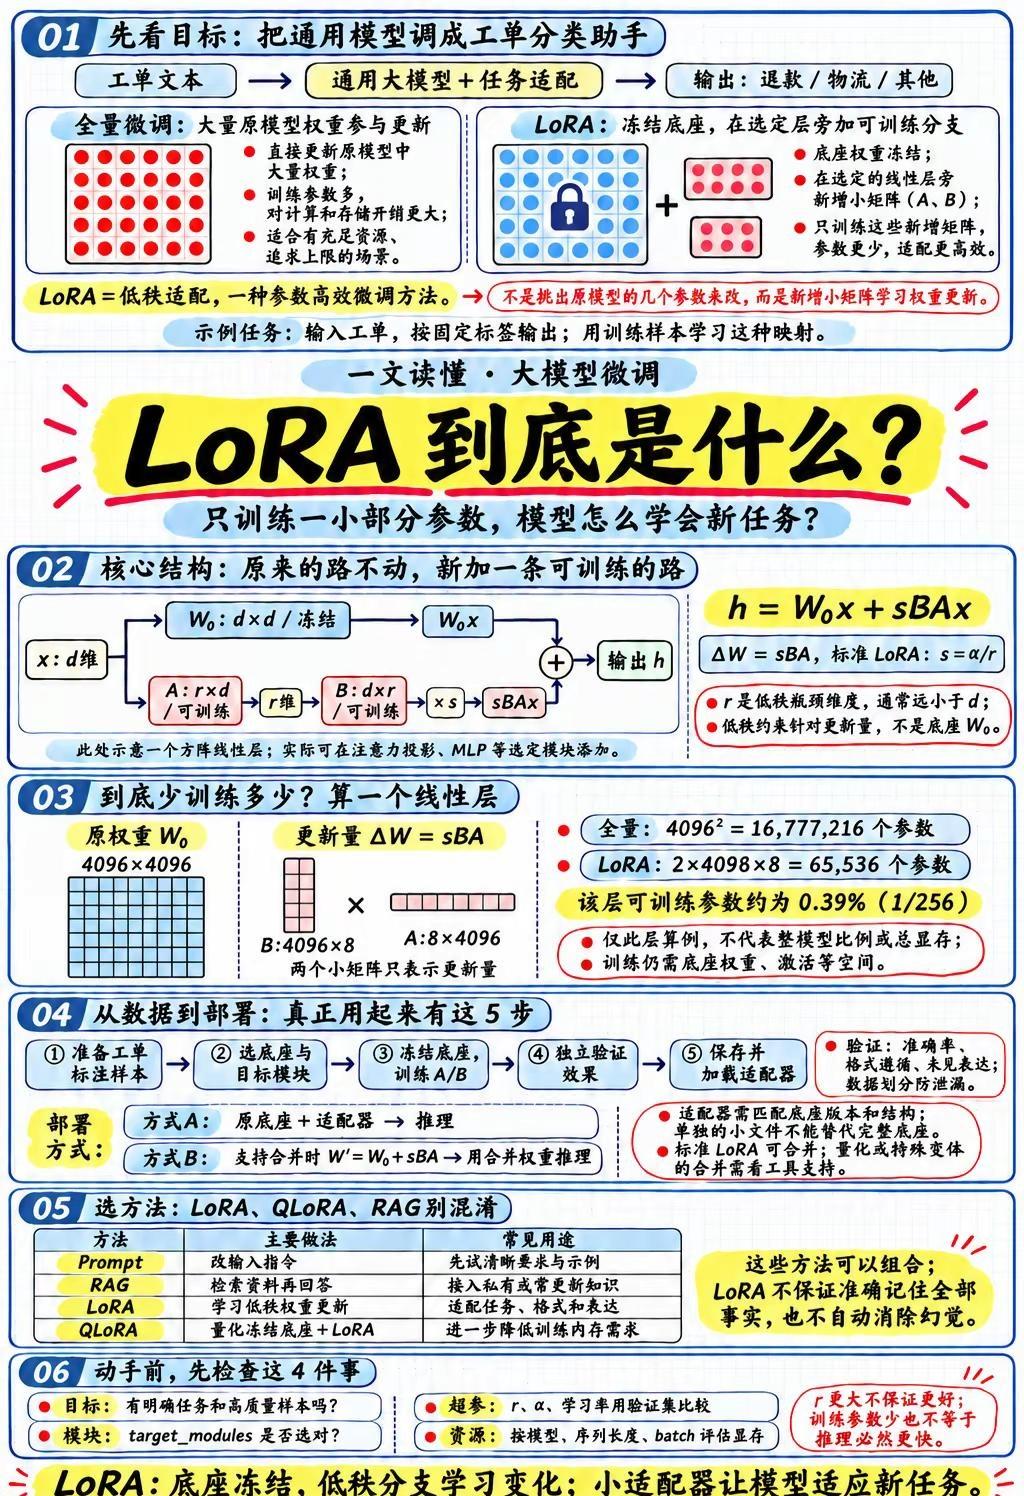
一文读懂LoRA:少量参数怎么微调大模型。都说 LoRA 能用少量参数微调大模型,但它到底训练了什么?🤔 拿“把通用模型调成工单分类助手”举例:全量微调会更新大量原模型权重;标准 LoRA 则冻结底座,在选定线性层旁新增两个可训练的小矩阵 A、B。 输入同时走两条路:① 原模型分支:W₀x② LoRA 分支:sBAx最后相加,得到这一层的输出。 关键点:低秩的是“权重更新量”,不是把原模型压成两个小矩阵。 算一个层就明白了👇4096×4096 的权重矩阵有 16,777,216 个参数;取 r=8,A、B 合计只有 65,536 个参数,约为该层的 0.39%。这只是单层可训练参数的比较,不等于整模型显存也降到 0.39%。 图里还讲清了:• 从样本准备、选择模块,到训练、验证与加载适配器• 为什么适配器小文件还需要匹配的底座• LoRA、QLoRA、RAG 分别在解决什么问题• 动手前该检查哪些超参与资源条件 记住一句:LoRA 让小分支学习任务变化,底座仍然是运行模型的基础。 建议收藏这张图,之后再看微调配置里的 r、alpha、target_modules,会更容易理解。 LoRA 大模型微调 大模型 人工智能