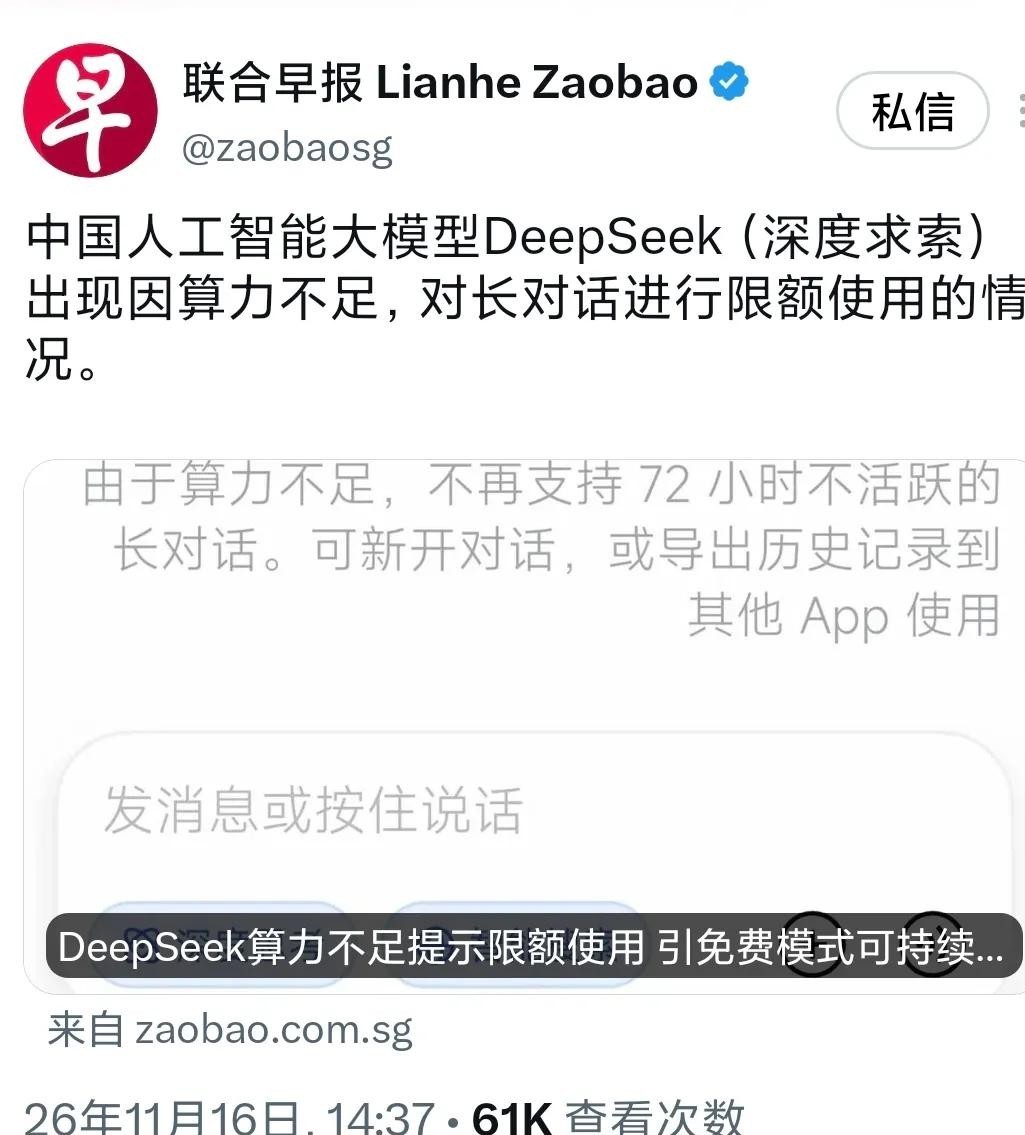
新加坡联合早昨天写道:“中国人工智能大模型DeepSeek出现因算力不足,对长对话进行限额使用的情况。”
我也没少用这个模型,最近确实感觉到了这种心有余而力不足。明明正在兴头上,正想跟它深入探讨几个复杂的逻辑,突然蹦出来个提示说资源受限。那种感觉,就像是刚点好菜准备大快朵颐,厨师却跑出来说后厨灶台不够用了,得排队轮着来。
说白了,这就不是技术行不行的问题,是实打实的烧钱竞赛。现在的模型动不动就搞个百亿千亿参数,还要维持高强度的交互,这背后那颗颗高性能硬件,电费、维护费都是天文数字。咱们普通用户用着低成本的服务,背后其实是厂商在硬扛着这些运营成本。
有些朋友吐槽这是倒退,我倒觉得这更像是一种行业阵痛。就像当年咱们用宽带,刚开始的时候也是限流限速。现在厂商敢这么大方地搞限额,其实也是一种理性选择:与其让所有人一起卡顿到无法使用,不如先保住核心对话的流畅度。
当然了,这也给国内的厂商提了个醒。算力这玩意儿,真就是未来产业的粮,手里没粮,心里真慌。咱们自己能做大模型是好事,但要是底层的调度优化和算力基础设施跟不上,上限也就卡在这儿了。
这种限额大概率不会是常态,只要硬件生态再撑一撑,或者优化方案到位了,体验自然会回来。但不管怎么说,咱们现在用的每一轮对话,那都是在为整个行业的成长买单。