[CV]《Unbundling Multimodal Vision Encoding》E Brown, C Hoang, S Qian, S Li… [Meta FAIR & New York University] (2026)
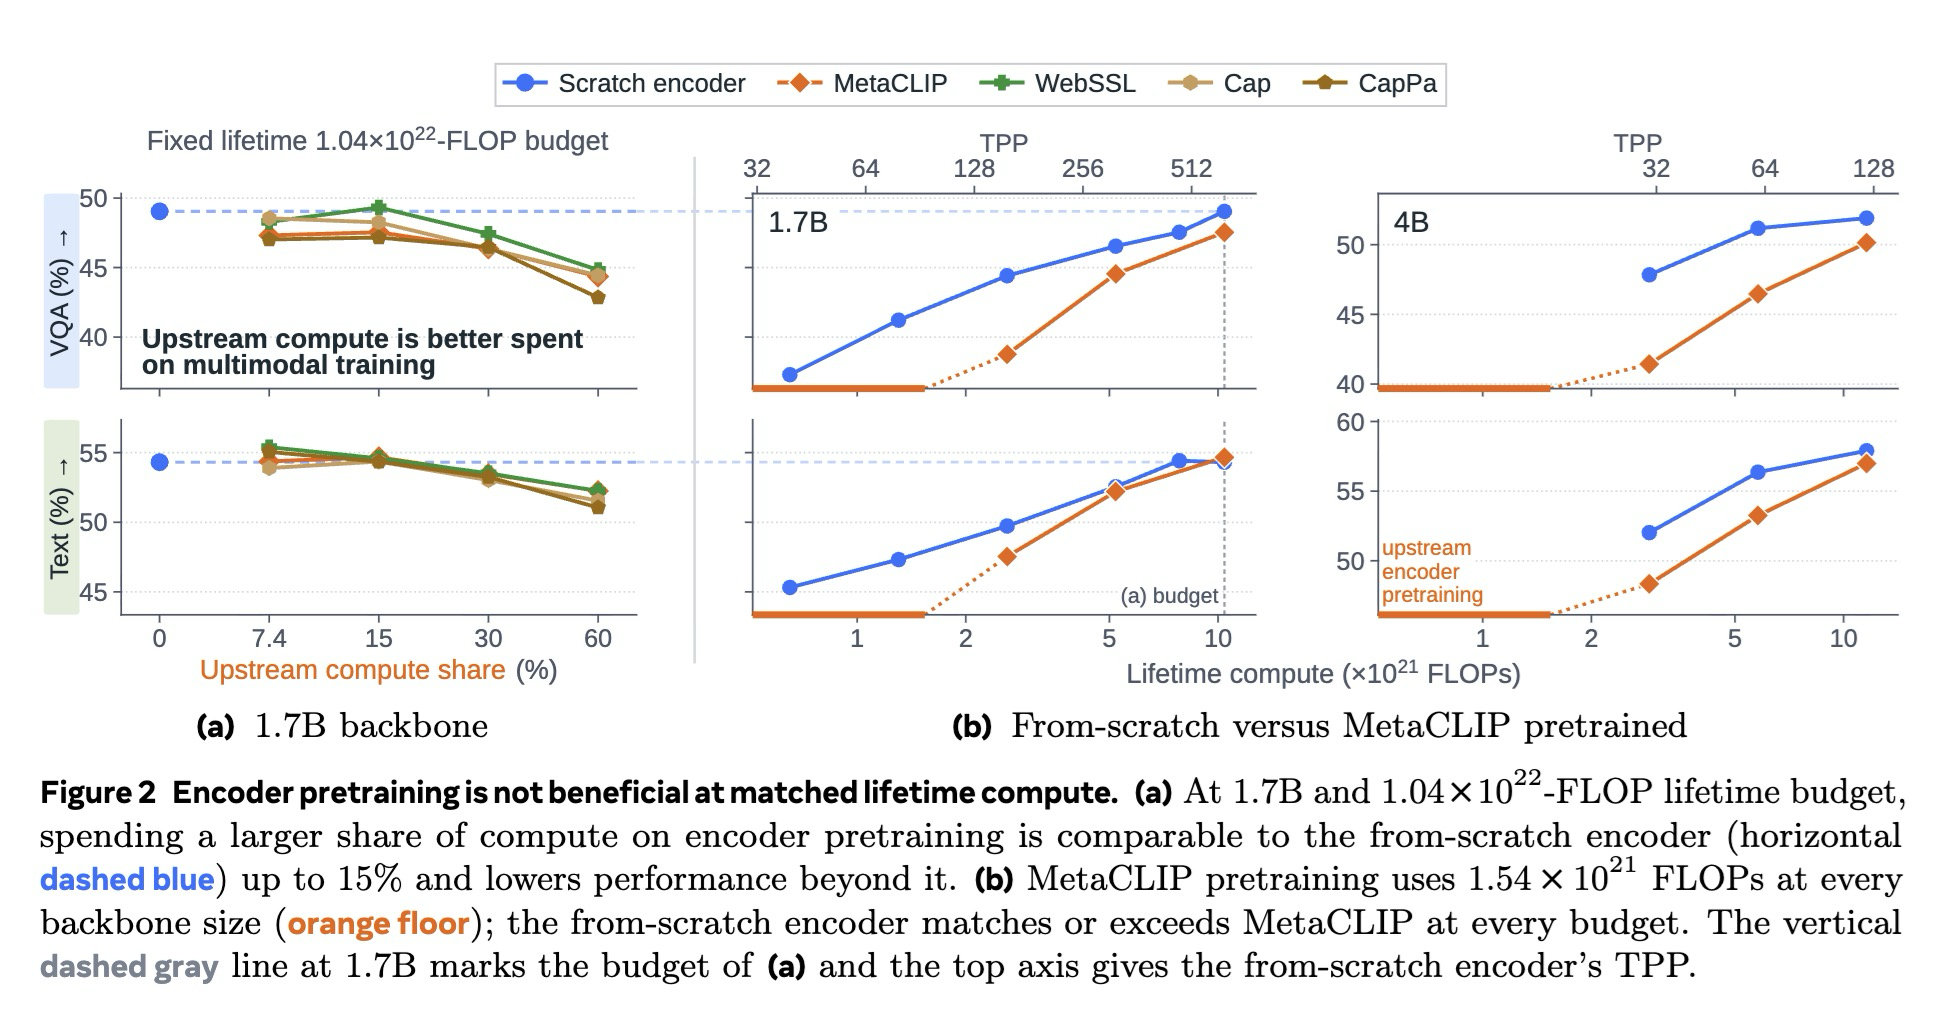
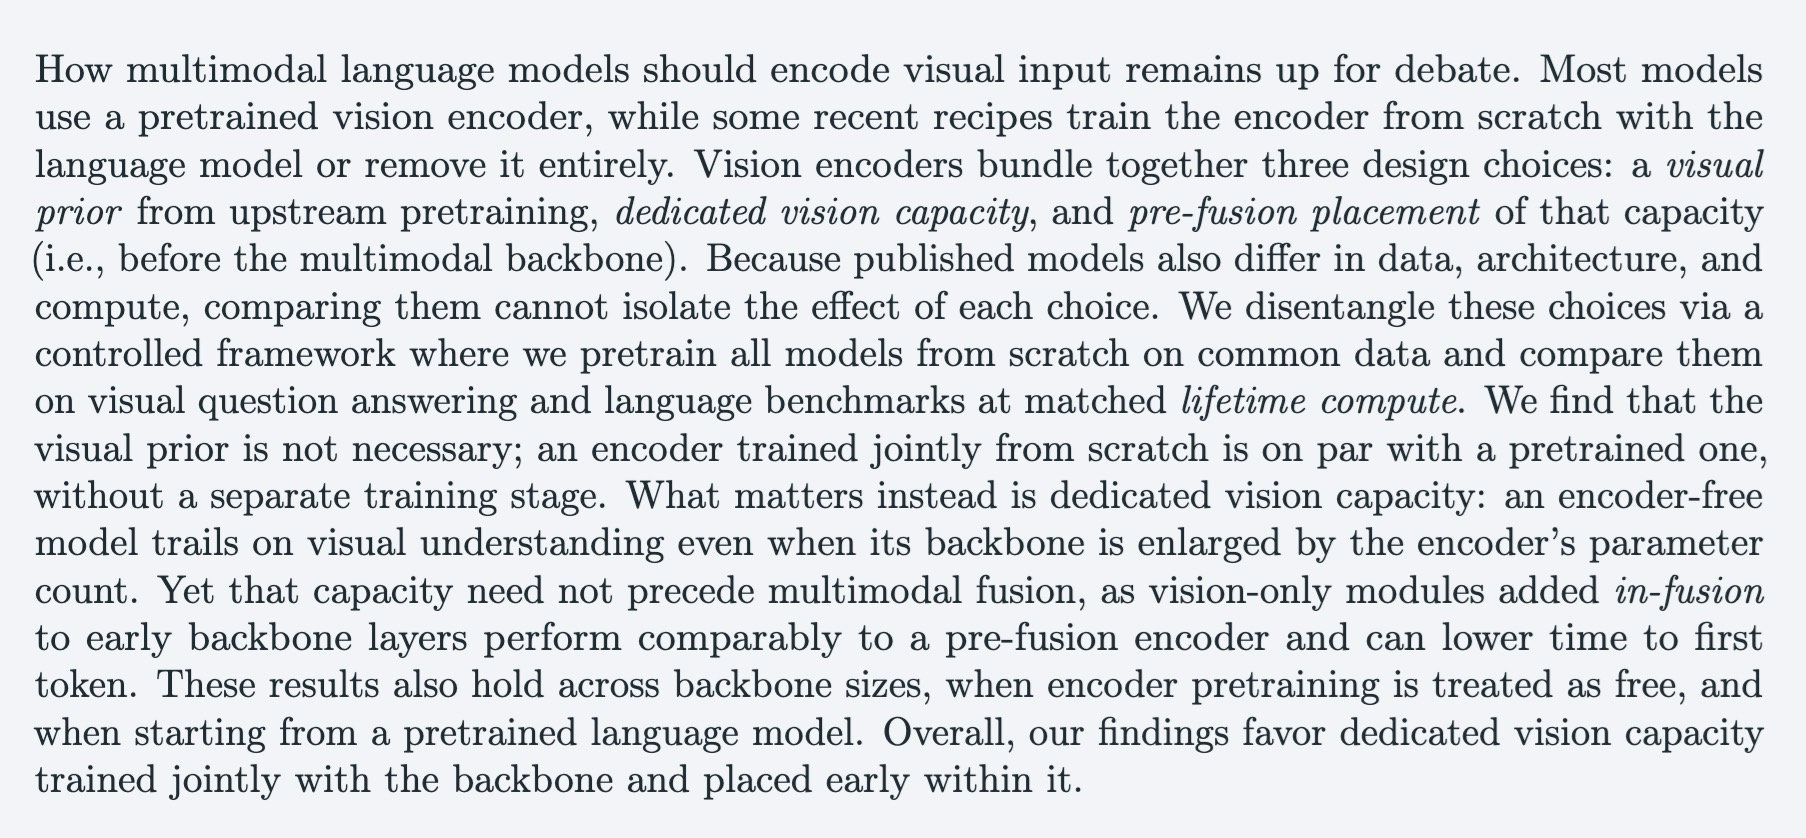
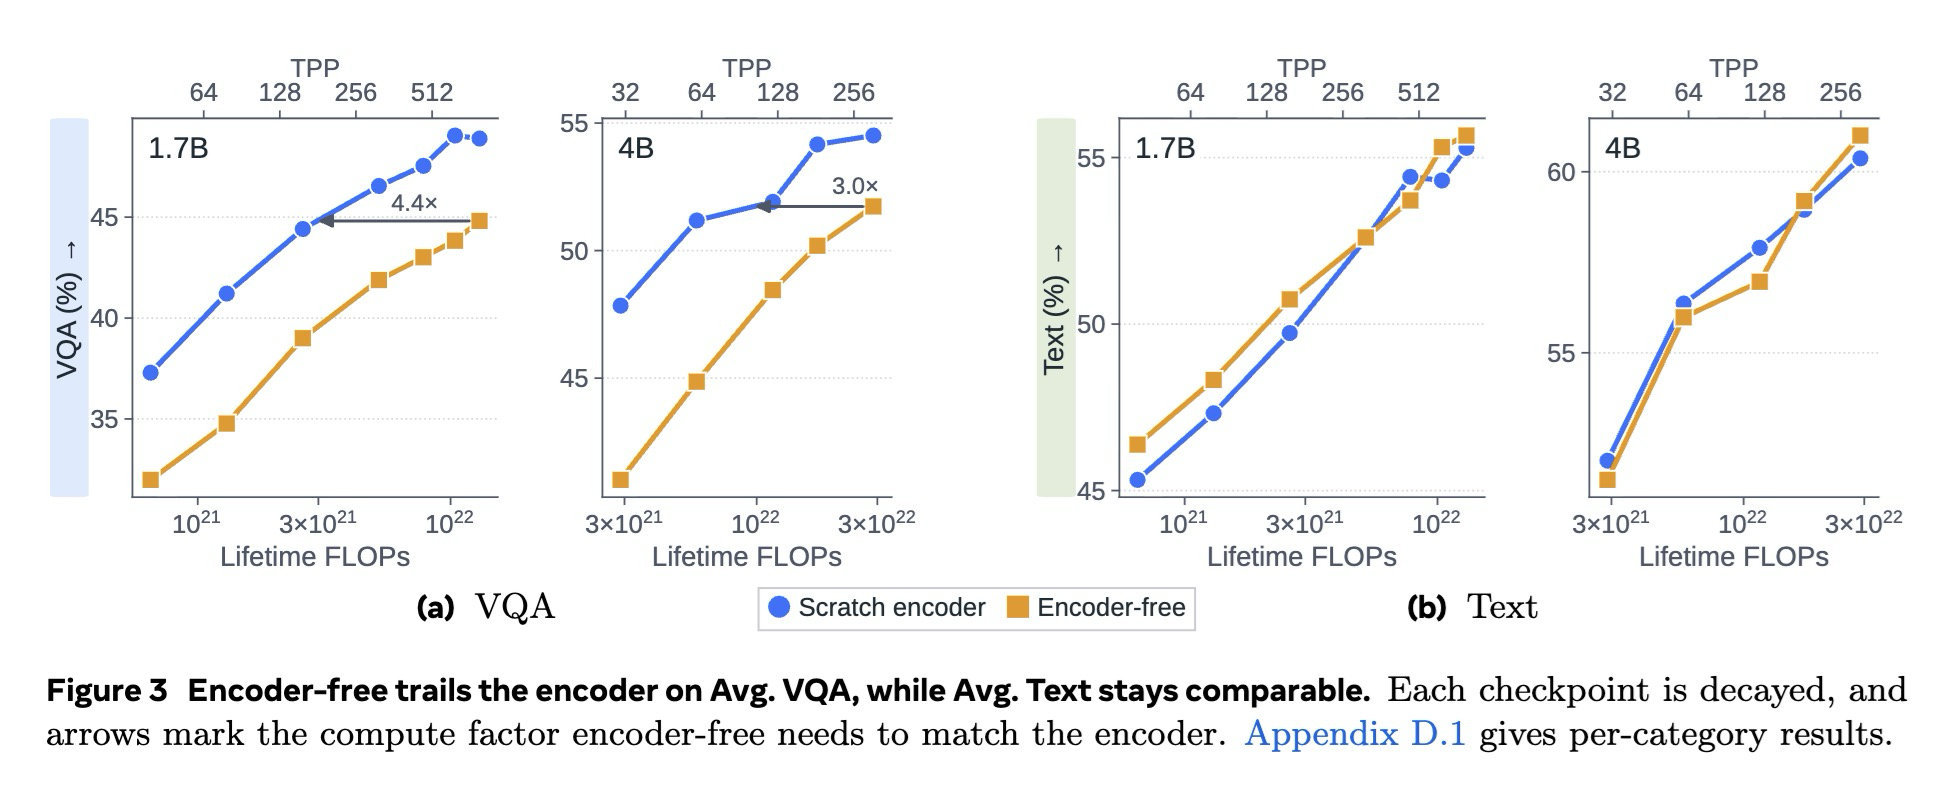
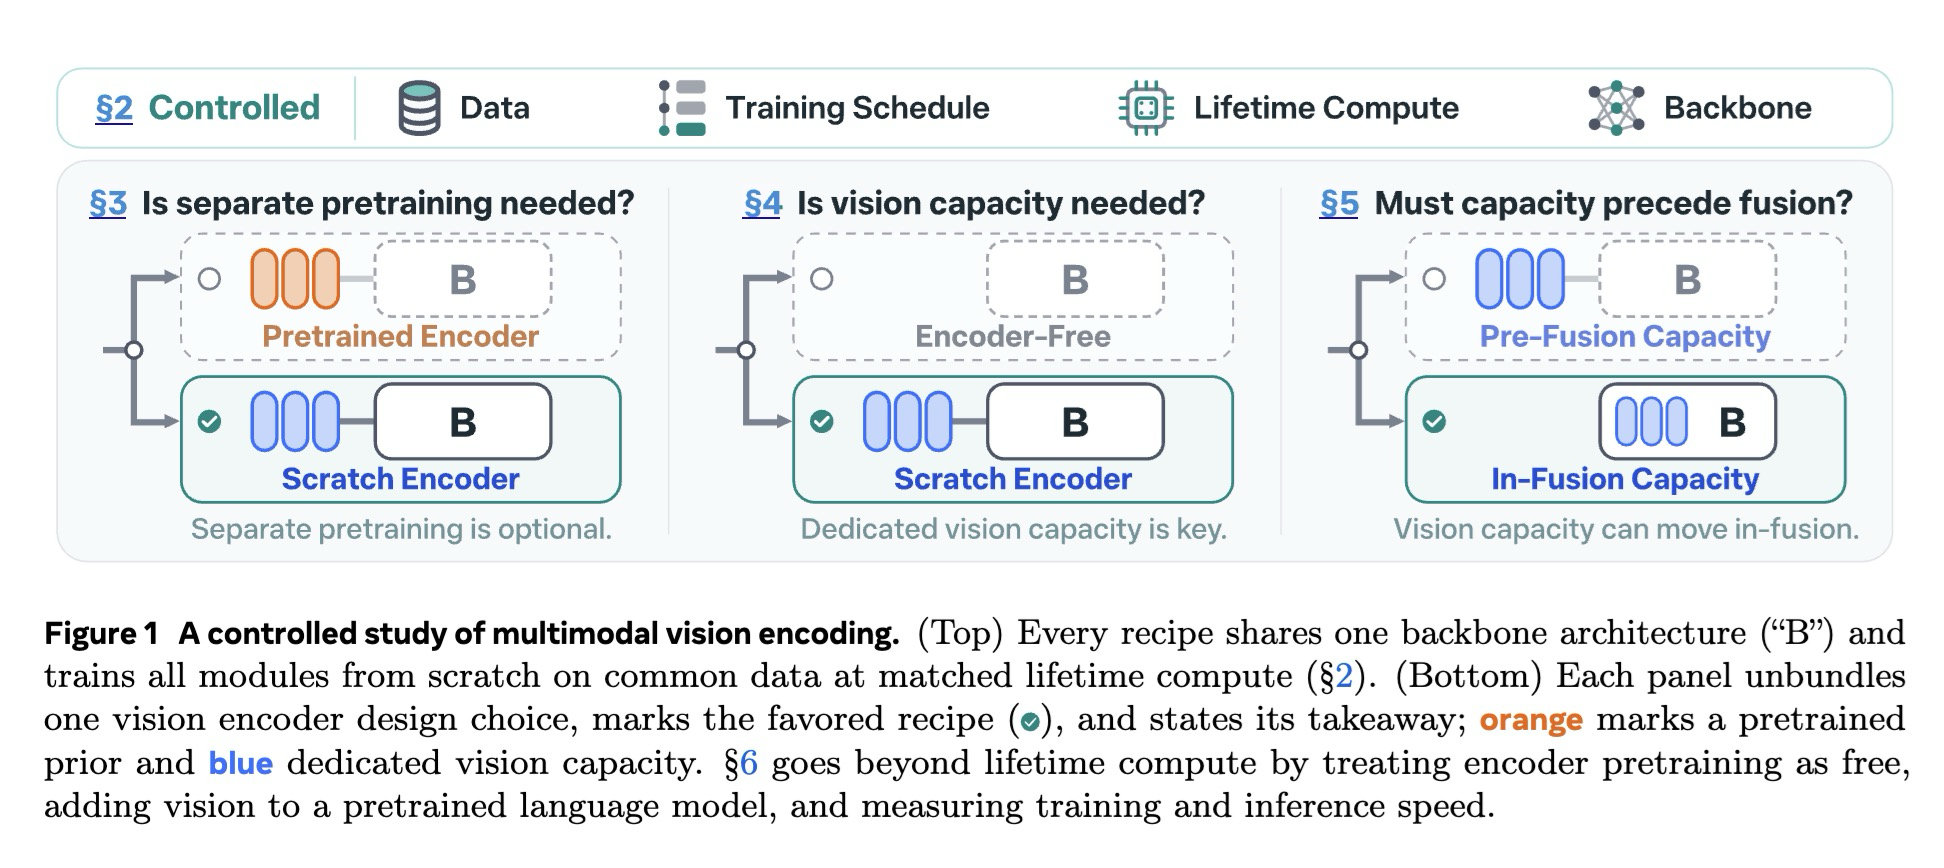
在多模态领域,视觉编码是一个悬而未决的难题。过去的方法受困于无法剥离模块效用,本质原因是将预训练先验、专属参数与前置融合强行捆绑。
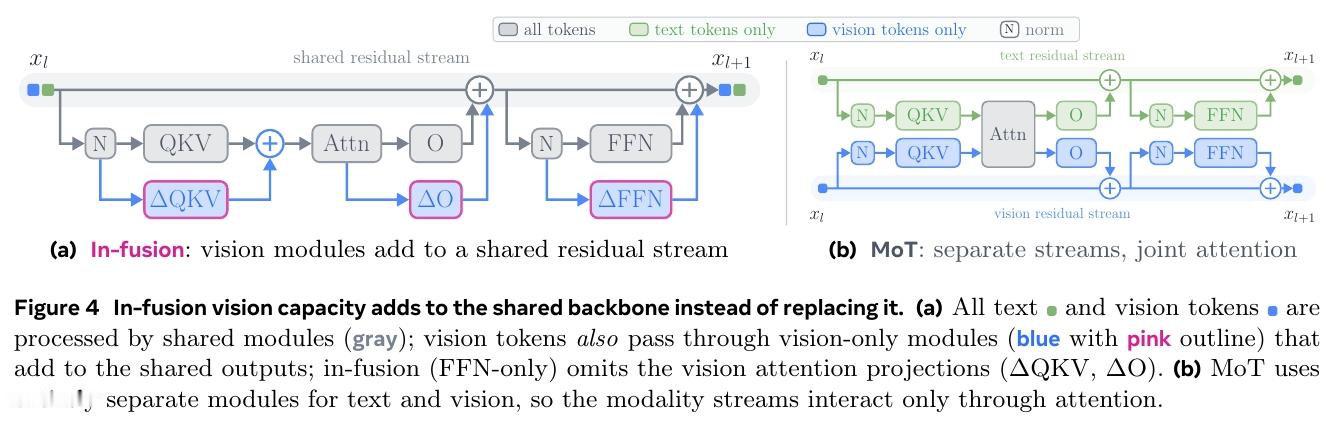
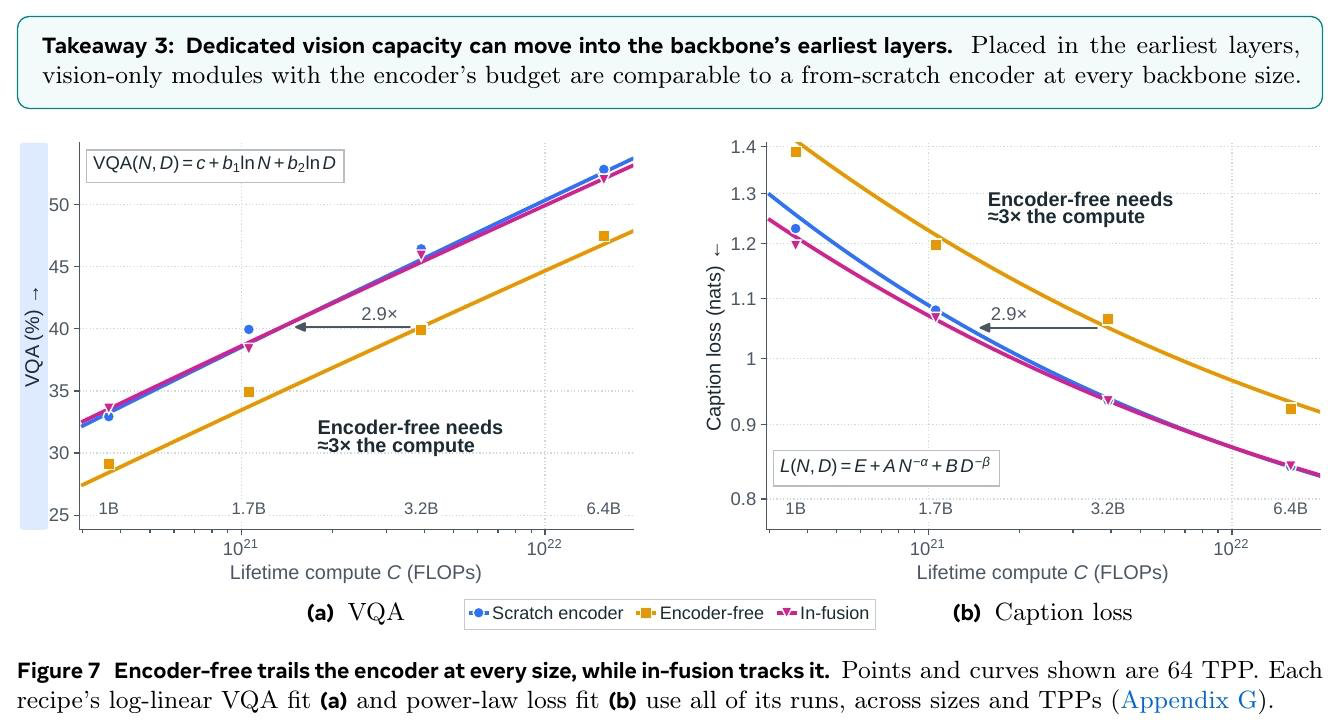
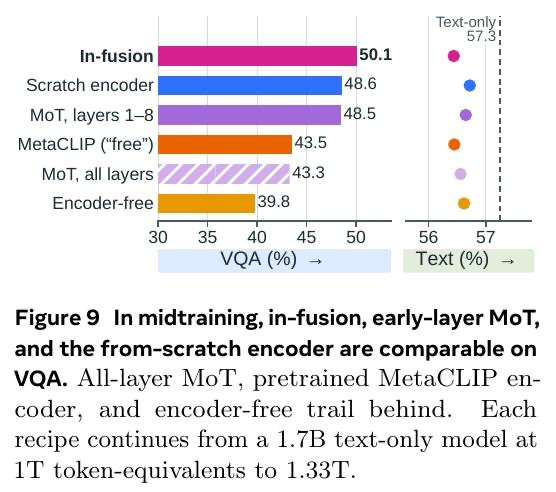
本文的核心洞见是:把前置编码器重新看作主干内的专属容量。由此,摒弃预训练,将视觉模块直接嵌入主干早期这一关键操作使问题得以解开。
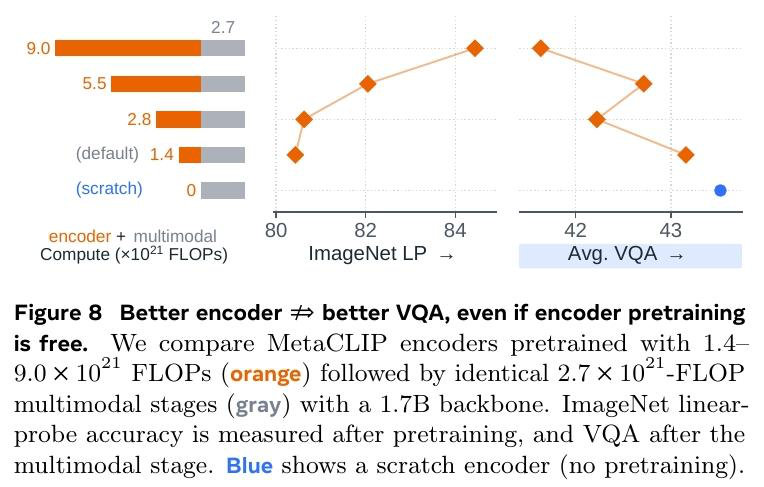
这项工作真正留下的遗产是粉碎视觉预训练教条。它为后来者打开的新门是首字极速响应的一体化架构,但尚未跨过的门槛是稀疏专家网络与高分辨率验证。
arxiv.org/abs/2611.17334 机器学习 人工智能 论文 AI创造营