国产芯片逆袭:模拟计算如何颠覆全球算力格局
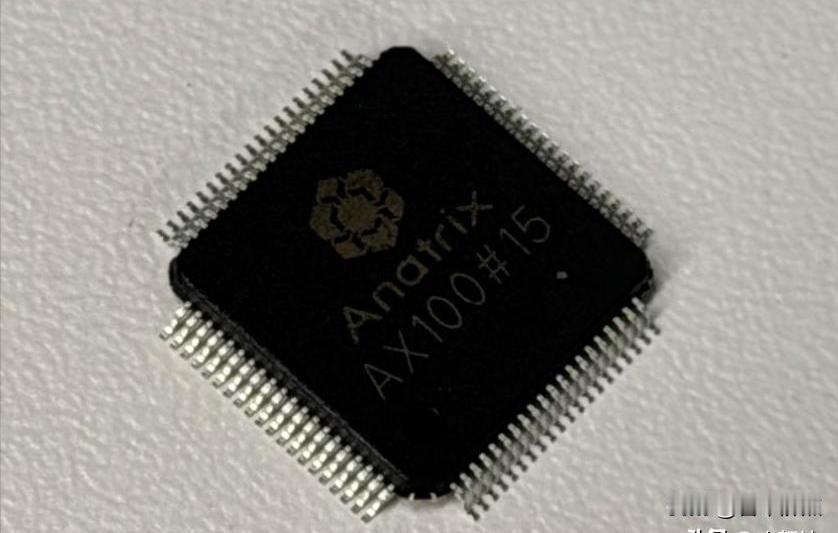
在全球芯片行业风起云涌的2023年秋季,鲜有人注意到北京一家名为安纳智芯的公司悄然完成了芯片流片。这个消息一开始看似微不足道,但很快成为科技圈讨论的焦点。AX100芯片的诞生不仅为中国半导体行业带来新的希望,也让那些长期关注中美技术竞争的人感到振奋。过去十年,芯片领域一直被“数字计算”所主导,不管是互联网巨头还是新兴AI企业,背后都离不开英伟达等公司的GPU显卡。计算量的爆炸性增长让全球算力需求不断攀升,连马斯克都开始考虑购建核电站以满足AI训练的用电需求。微软甚至想重启三里岛核电站,只为让算力不被电力瓶颈拖住脚步。这种疯狂追求算力的现象让人不禁思考,难道芯片行业只有一条路可走吗?
深入观察,数字计算的本质其实像是用无数次加减乘除去拆解复杂问题,效率低且功耗高。芯片厂商不得不依赖更先进的光刻机,将晶体管做得越来越小。ASML的EUV光刻机成为全球科技竞争的核心资源,中国在这方面受到的限制也越来越明显。如果继续在数字芯片的赛道上拼制程,永远追不上那些掌控核心技术的公司。正是在这样的背景下,模拟计算重新被提上日程。模拟计算不是靠二进制运算,而是直接利用物理定律解决问题。举个例子,如果想知道水流如何穿过复杂地形,与其计算每滴水的流速、坐标,不如直接做个模型,倒水进去,观察结果。模拟计算芯片就是这样,把复杂的矩阵方程转化为物理电路,通电瞬间便得出答案,速度和能耗远超数字芯片。
不过,模拟计算长期被认为不够精准。环境温度、杂音等因素会影响结果,科学界一直觉得它无法满足现代高精度需求。直到2025年10月,北京大学孙仲团队在《自然·电子学》上发表论文,将模拟计算精度提升至千万分之一量级。这个突破直接改变了行业对模拟计算的看法。AX100芯片正是基于这项技术,单次矩阵方程求解时间不到100纳秒,功耗仅80毫瓦。相比传统芯片,速度提升了三个数量级,能耗下降了两个数量级。英伟达靠拼晶体管尺寸,而AX100通过物理定律实现降维打击,完全绕开了光刻机的制约。AX100的生产过程无需依赖西方封锁的先进制程光刻机,采用国内成熟工艺即可实现自主可控。这一突破让中国芯片产业真正实现了技术上的独立。
在实际应用方面,AX100芯片已经在AI训练、智能机器人和无线通信领域展现出惊人的能力。比如在大模型训练时,使用Autoencoder和Transformer模型,训练消耗分别降低了92%和56%。在机器人运动控制和规划上,算法速度提升了150%到500%,SLAM定位建图效率提高了200%到500%。无线通信领域,128×128规模矩阵下,吞吐量提升20到207倍,能效提高27.6到61.3倍。与之形成鲜明对比的是,传统数字芯片如GPU和ASIC在功耗与速度上明显受限,难以满足未来AI和通信的极端需求。美国科技公司曾尝试通过FPGA和定制ASIC芯片提升效率,但始终无法突破能耗与算力的极限。安纳智芯的模拟计算芯片则用全新的思路解决了这个行业难题。
值得一提的是,AX100芯片的研发和量产仅用了一年时间,这背后是中国芯片制造产业链的成熟与强大支撑。无论国外如何限制核心设备出口,AX100都能在国内实现全链路自主生产。类似的技术突破在全球并非孤例。2022年,韩国SK海力士也尝试用混合型存储芯片提升AI推理速度,但受限于制程与能耗,效果远不如模拟计算芯片。2023年,美国斯坦福大学研究团队发布了基于光子计算的新型芯片,试图用光信号替代电信号提升速度,但在精度和稳定性上仍面临巨大挑战。反观AX100,通过精准的物理映射和成熟工艺,成功解决了行业难题。
当然,模拟计算芯片也有风险和边界。它虽然在特定场景下效率极高,但并非所有计算任务都适合用物理模拟。例如加密算法、金融计算等需要极高精度和复杂逻辑的领域,数字芯片仍有不可替代的优势。未来,模拟计算芯片和数字芯片可能会形成互补共存的局面。安纳智芯CEO向锐在接受采访时表示,AX100与传统GPU架构完全不同,首次让中国企业有机会定义计算范式。过去中国企业一直在冯·诺依曼架构下追赶西方规则,如今模拟计算芯片为行业提供了新的可能性。在算力即将触及极限的时代,国产芯片终于有机会用自己的方式开辟新赛道,重新书写计算硬件的规则。