说帮我“设计一个能降解塑料的酶”真做到了
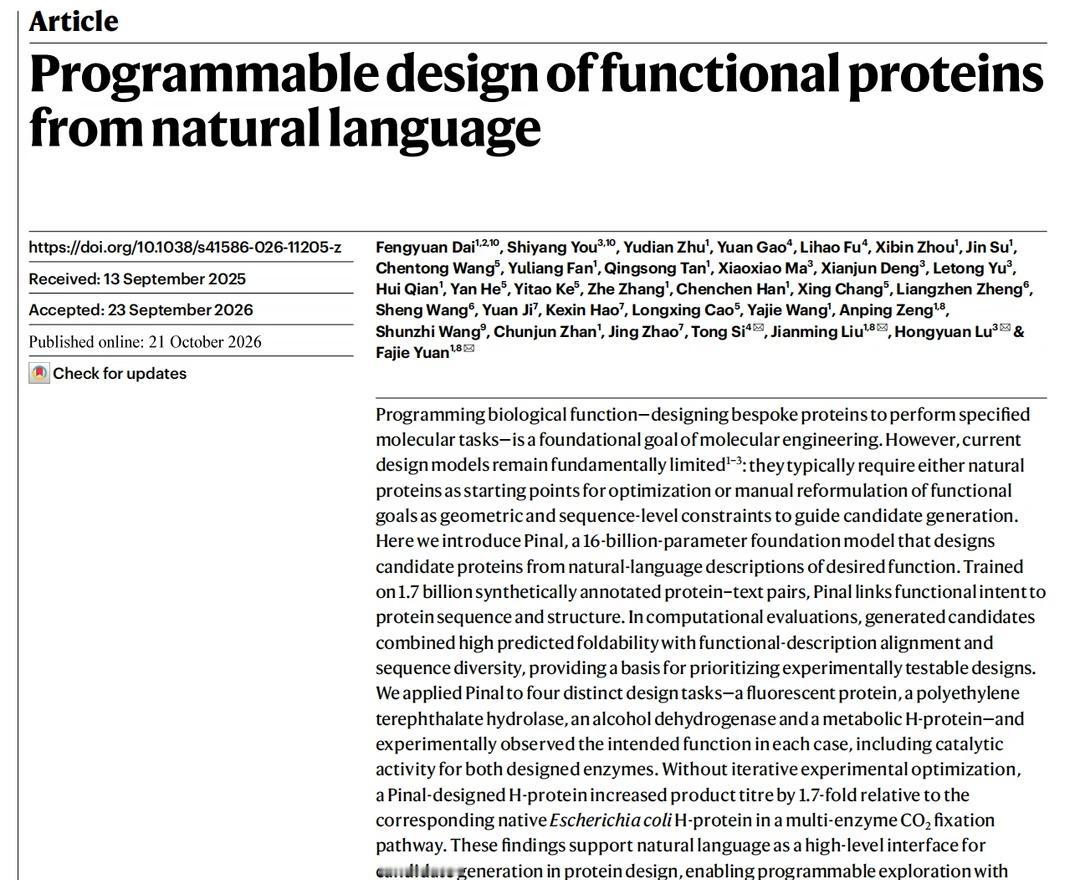
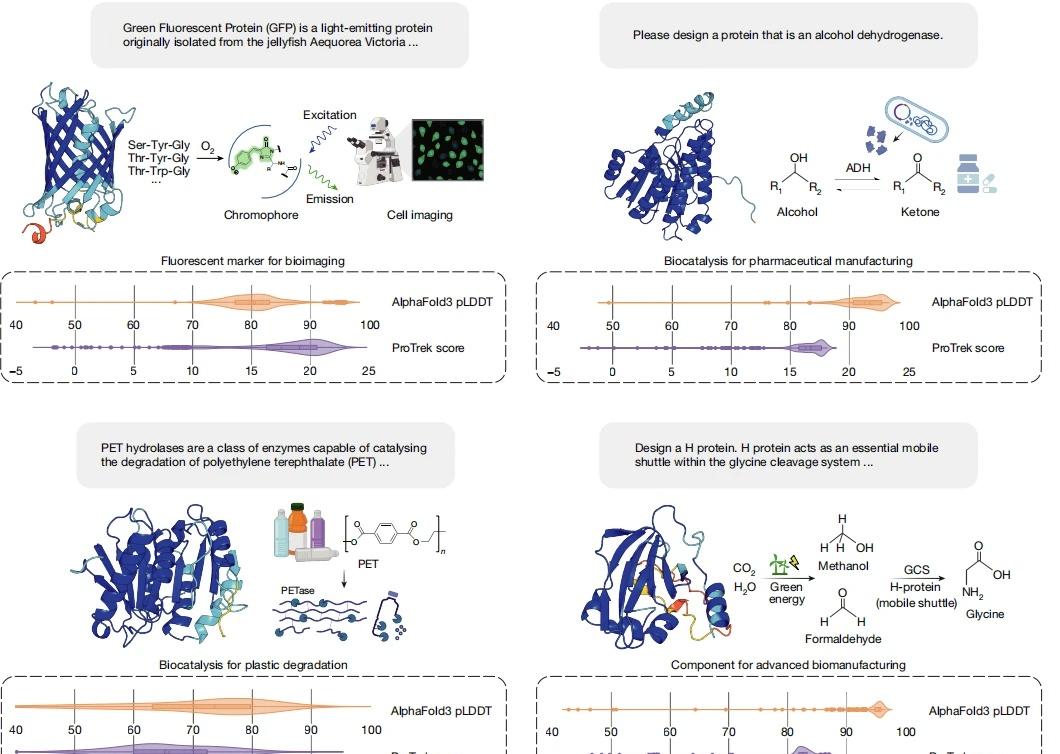
Nature 刚发了个叫 Pinal 的模型:写一段话描述你想要什么蛋白,它直接给你一条蛋白序列。160 亿参数,这个方向目前最大的。
蛋白质是一条由 20 种氨基酸拼成的长链,链怎么折叠起来,决定了它能干什么活。以前想让 AI 造一个新蛋白,你必须先把自己想要的功能翻译成结构坐标、关键位点、几何约束,这不是没干过几年结构的人能干的事。
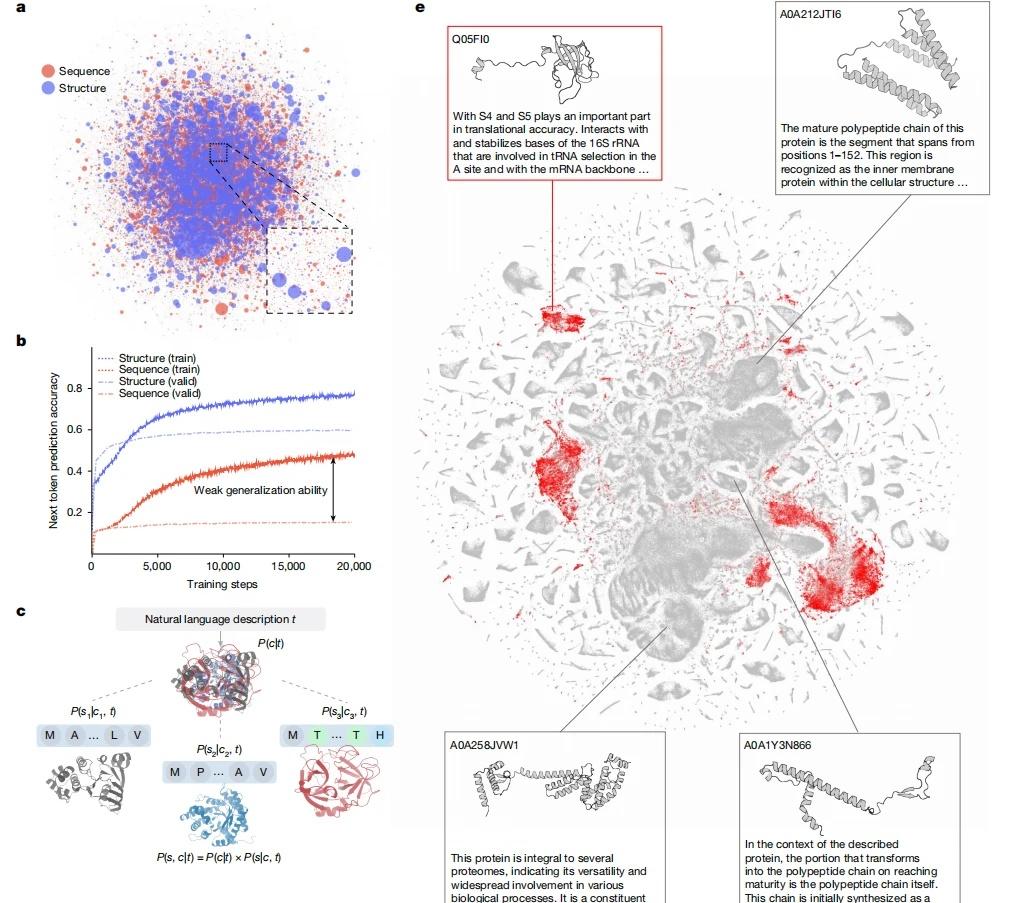
论文里最关键的一步是一个对照实验。他们训练了两个完全一样的模型,用的是同一份数据、同一套训练设置,唯一区别是让它们猜的内容不同:一个直接猜氨基酸排列,一个先猜局部的折叠形状。
结果直接猜氨基酸的那个,准确率 0.1,随机猜是 0.05,基本没学会。先猜形状的那个,到了 0.6。
道理不复杂:一句话能对应的氨基酸序列有上亿条,可写的方式太多;局部形状的种类少得多,先定形状,等于先把答案框住。这个对照还能成立,靠一个巧合:描述折叠形状的字母表正好也是 20 种,跟氨基酸一样多,所以能只换一个变量比。
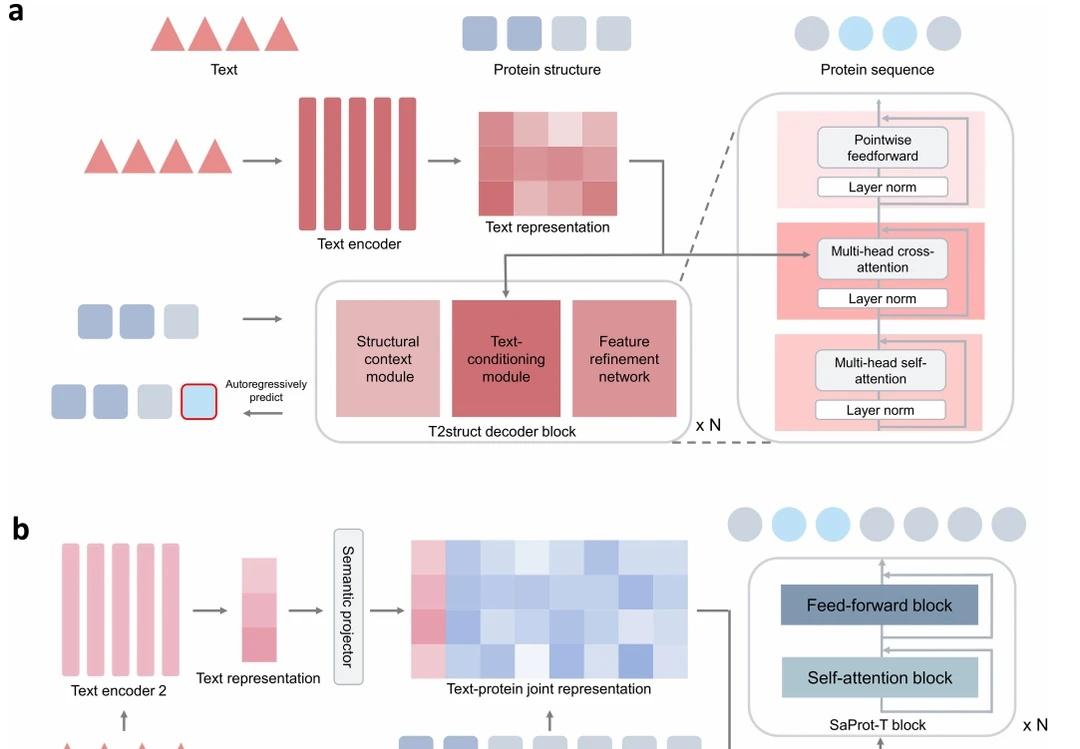
于是 Pinal 就分两步:先定形状,再定序列。第一步用 155 亿参数的大模型把文字变成“折叠形状序列”,第二步用一个小模型(7.6 亿),在形状加原文的双重约束下反推氨基酸。
短板:两步各自取最好的解,不等于整体最好的解。这是设计的天然代价,也是后面最该改的地方。
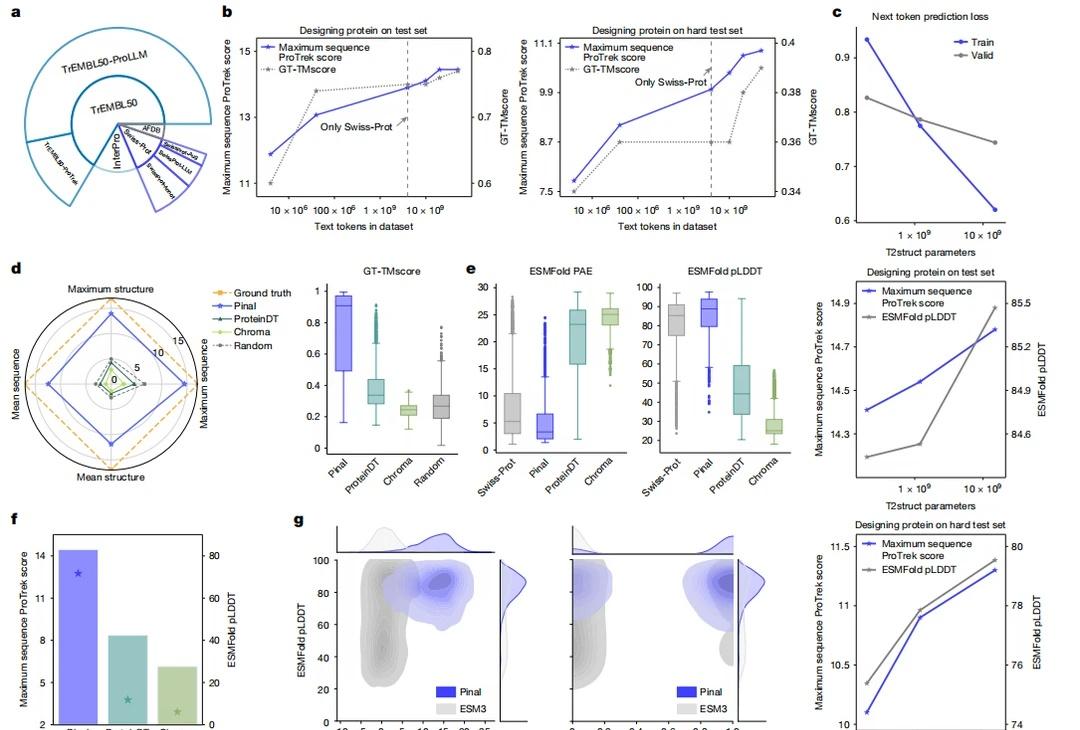
数据是主要的工作量。人工标注的蛋白库只有 54 万条,不足以训练这么大的模型。他们的办法是用一个“蛋白-文字”匹配模型,给上亿条没描述的蛋白自动配说明,再用 GPT-4 把每条描述改写成十种说法,最后凑出 17 亿对。三个训练阶段总共用掉 5 万张 H800 显卡小时。
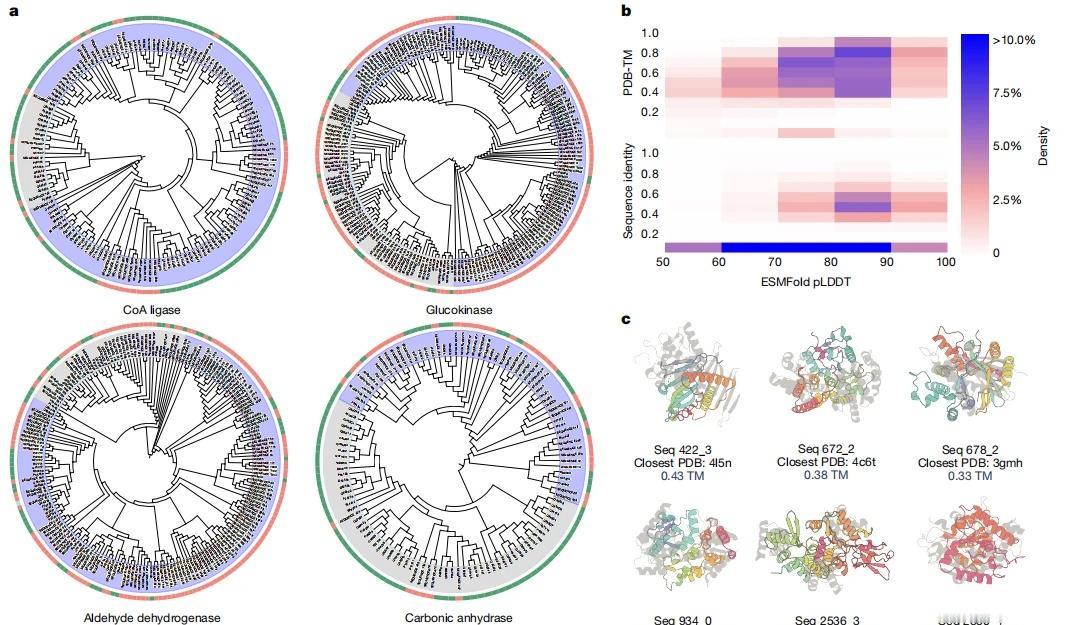
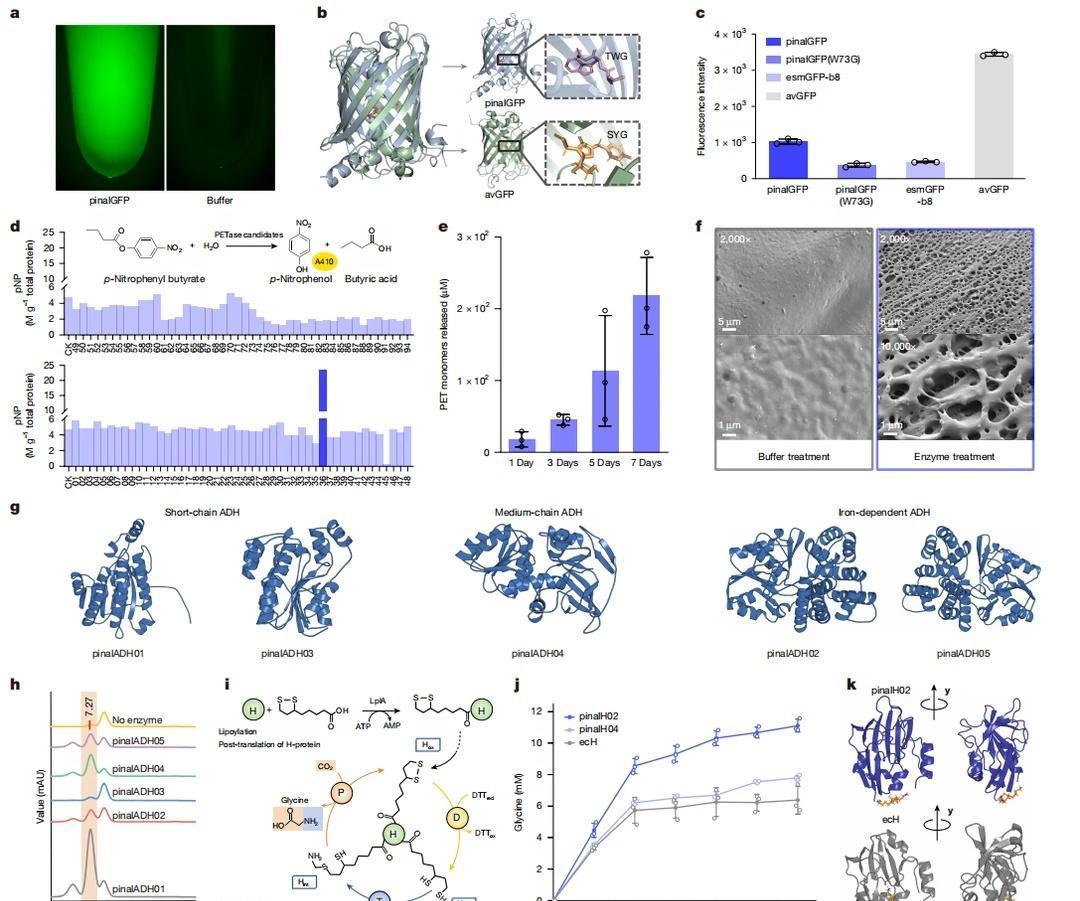
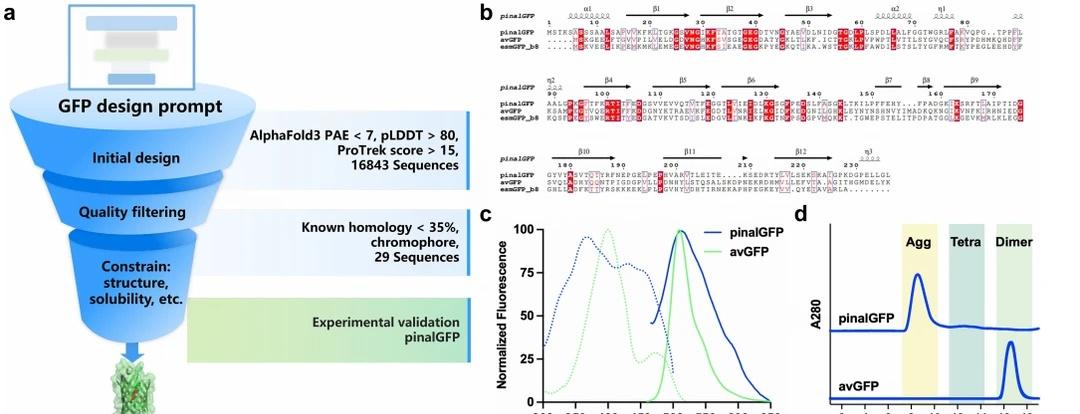
结果给了四个:荧光蛋白、降解塑料的酶、醇脱氢酶、一个代谢通路的搬运蛋白,四个都做出了活性。最让人注意的是最后一个:没做任何一轮实验优化,直接放进多酶体系运行,甘氨酸产量比大肠杆菌天然的那个高 1.7 倍。分子动力学里能看到原因:天然版本的摆臂卡在疏水口袋里,它这条是松开的。
代码和权重都开源了,网页服务也能直接试。
它真正改变的是输入端。以前门槛在“会不会把需求翻译成结构约束”,现在这步被语言接管了。但两步走丢掉了整体最优,形状描述也丢掉了侧链信息。短期它适合当候选生成器,不适合替掉你手上的流程。
西湖大学 蛋白质设计 Nature 酶工程 生信分析论文 博士 AI4Science