StreamDuo:AI能解说陌生游戏吗?
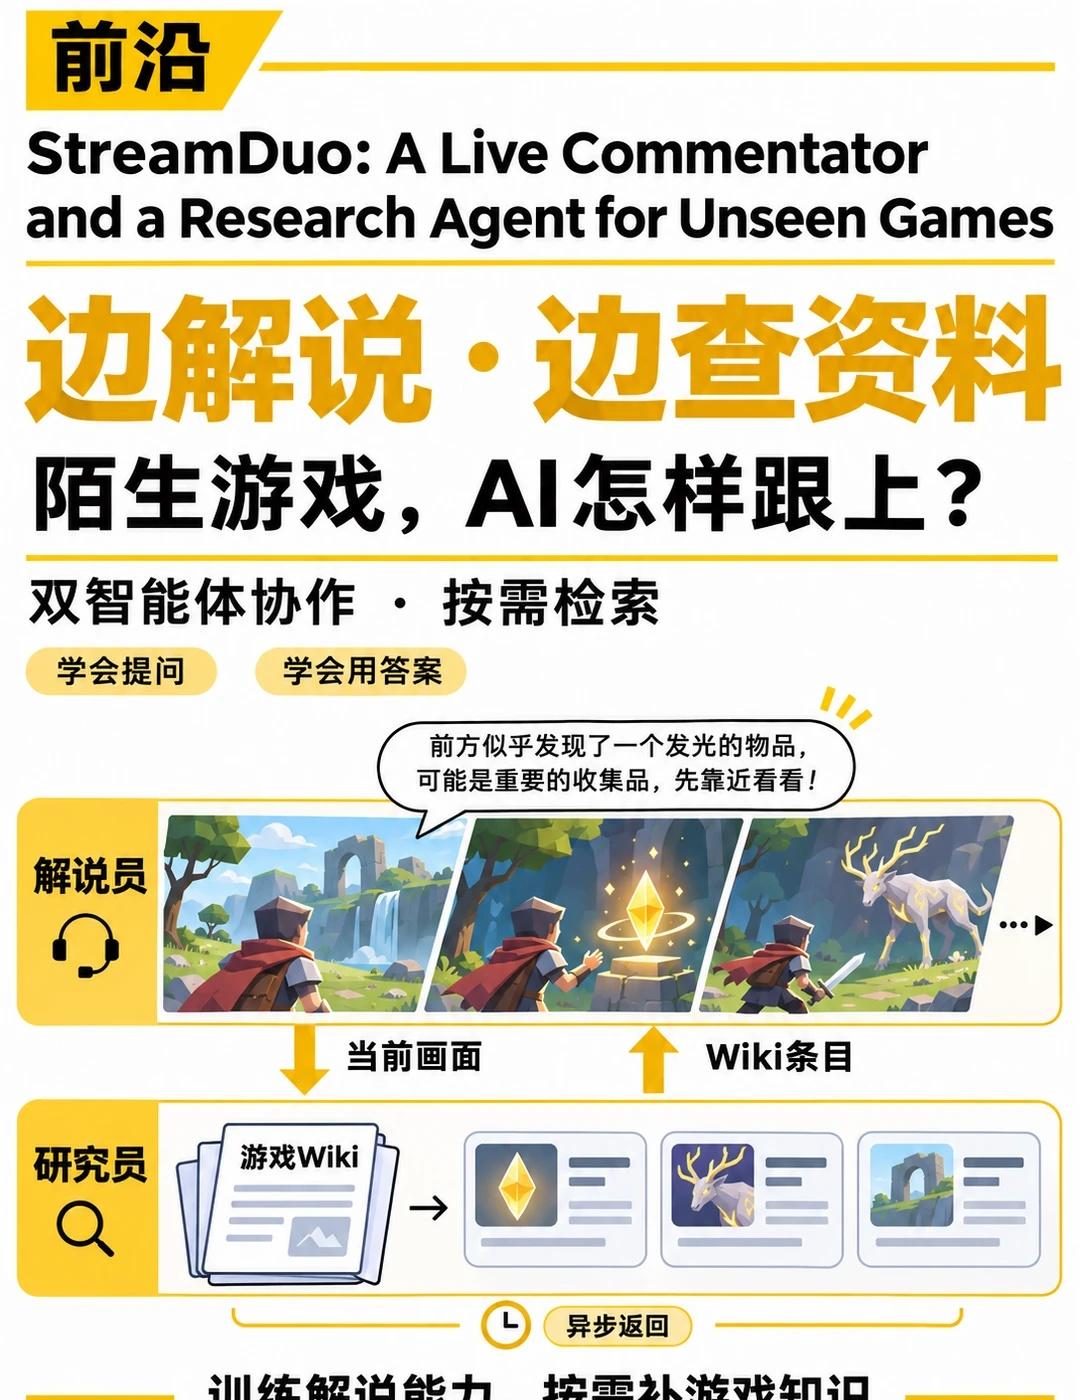
游戏解说AI换个游戏,可能还知道何时开口,却叫不出眼前角色的名字。StreamDuo把解说和查资料分给两个智能体:前台解说员持续看流,后台研究员按需看截图、查Wiki,把陌生实体的知识补回来。
接口设计很关键。不认识角色时,解说员往往也描述不好它,所以请求直接携带当前画面。冻结的研究员从画面提出检索词,用BM25搜索游戏Wiki,再核对候选,返回至多三条名称、类型和简短说明。答案异步进入历史,解说员继续逐秒判断是否说话,避免查一次资料就让直播停住。
真正需要训练的是“什么时候值得问”。第一阶段用冻结副本比较:有、没有理想条目时,人类解说句子的对数概率相差多少。高增益时刻被提前两秒标成请求点,让模型学习有用的求助时机。这里的信息增益是训练代理指标,不是对未知知识的万能检测器。
第二阶段教它使用有噪声的答案。学生看到可能混有干扰项的结果,生成自己会说的句子;同模型的冻结副本看到理想答案,指导这些句子的逐词分布。教师还通过有无答案的对比强化条目的作用,学生用反向KL学习。这样训练覆盖的是自身生成时会犯的错,而非只模仿干净的人类句子。
训练中,源游戏实体名还会按片段一致地随机改名,减少死记名称的捷径。实验只用《博德之门3》的10286个片段训练,在另外十个游戏的2470个片段上测试,目标游戏知识通过Wiki提供。
与同数据重训的Proact-VL相比,按人类解说实体匹配统计的召回由8.2%升至11.6%。知识指标只统计每段前126个词,限制靠多说话抬高召回。另一个口径下,全部实体提及中,误借源游戏名称的比例从9.9%降至1.0%;这不是整体幻觉率,也不是视频出错的比例。
请求更频繁也未必更好。每三秒强制查询时,实体召回更高,但实体F1和裁判给出的解说质量下降。论文因此强调按需获取、结合画面筛选,而非把检索结果都念出来。
它的意义是让可迁移的解说节奏与游戏知识分工,知识可以随目标Wiki切换。边界是“未见”只针对本次任务训练,基础模型是否预训练见过这些游戏没有被排除;研究员也会返错条目。固定两秒的返回节奏及单H100抽样测速,不等于任意硬件与负载下的延迟保证,质量评分也主要来自模型裁判。
多模态 检索增强