🔥AI圈炸了!训练速度翻倍,U-Net和Transform
扩散模型训练慢这事,真的折磨人。
U-Net的跳连和Transformer块放一起,看着挺合理,实际跑起来两边语义空间对不上,信息传不顺,训练又慢又费卡。
最近看到一个工作,把这个问题正面解决了:
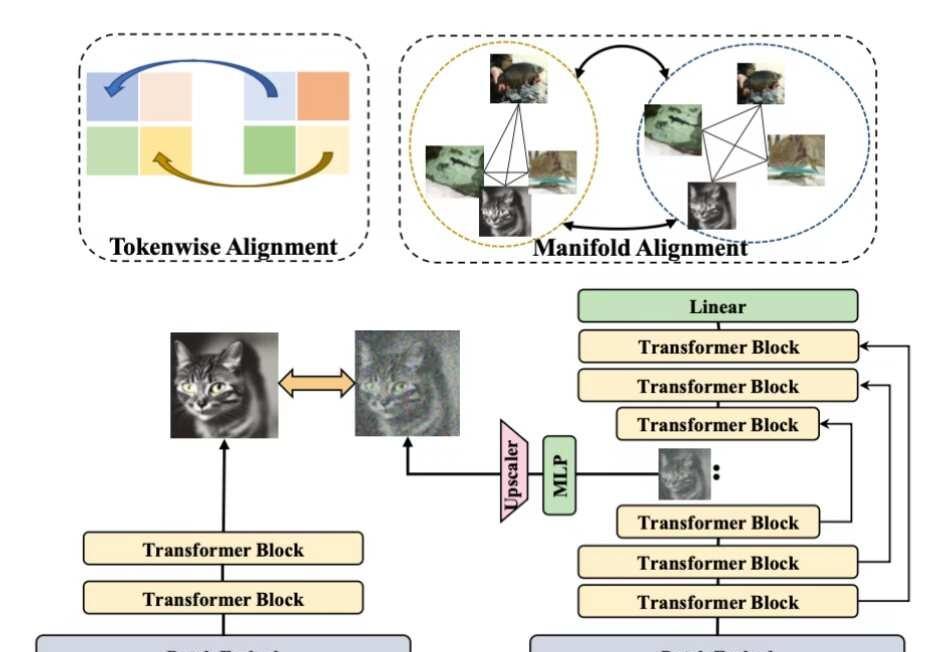
一是做了架构桥接,第一次系统性地让U-Net跳连和Transformer块在语义空间对齐,跳连信息能真正流进Transformer,不再是各跑各的。
二是加了流形损失,训练收敛速度直接翻倍,而且生成质量没掉。不是那种快了但糊了的假加速,是实打实提速一倍,出图还在线。
对搞扩散模型训练的人来说这个挺实用的,同样的算力能多跑一倍实验,省卡省时间。
有也在做U-Net和Transformer融合的吗,评论区聊聊你们训练一轮要多久。
AI论文 扩散模型 Transformer 深度学习 AI科研 AIGC 论文分享博士生日常 AI人工智能