🔥「Qwen4‑Max 正式发布!2.4T 稀疏 MoE,单任务成本直降 58%,百万上下文全天候协作」
11 月 16 日,阿里通义千问正式推出旗舰基座 Qwen4‑Max,定位全天候 AI 协作伙伴。它依托全新一代 Qwen4 稀疏 MoE 架构,在参数规模、长上下文、原生视觉与推理效率上同步升级,同时大幅下压调用成本,指向“真实生产力交付”这一轮大模型竞争主线。
基础规格:模型总参数达到 2.4 万亿,单 Token 激活约 71B,额外搭载 328B N‑gram Embedding 参数;自带原生视觉能力,支持百万 Token 上下文窗口,适合需要载入海量文档、代码库与多素材的长周期 Agent 任务。
目前 Qwen4‑Max 已经上线千问 AI 平台开放 API,缓存命中每百万 Token 最低仅 0.5 元;开发者也可以通过阿里 Token Plan 调用,普通用户可在千问办公、Qoder、千问 App、Qwen Studio 内抢先体验。官方同时确认:Qwen4 系列中小尺寸版本会陆续开源放出。
1️⃣架构:三重升级的稀疏 MoE
整套架构在注意力、残差、嵌入三个维度做系统性改造,是这次效率提升的根源:
- 长序列压缩通路:每四层结构里,三层采用 Gated DeltaNet,持续压缩、沉淀历史状态;剩余一层使用 QSA,按块筛选相关上下文,削减长上下文的算力开销;- 门控残差分支:将 Gated Residual 扩展为四条并行分支,强化跨层信息流动,对复杂推理、多步骤任务更友好;- N‑gram Embedding:以查表方式捕捉局部词元模式,用很低的算力开销扩充模型表征容量。
训练稳定性同样是亮点:2.4T 规模下预训练曲线平稳,没有明显损失尖峰。基座在知识、代码、问答、STEM 四类任务上的 BPB 在参评模型中最优;对比同为 2.4T 的上代版本,BPB 下降 5%–13%,单 Token 激活参数减少约 25%,做到“更少激活、更强能力”。
评测、效率与成本:
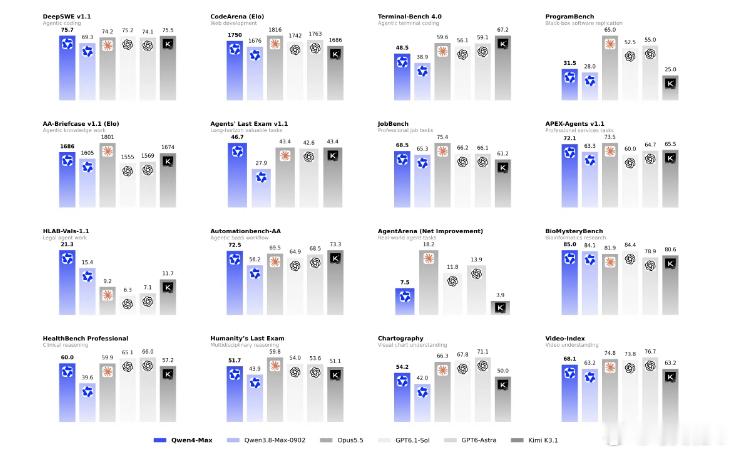
在基准测试中,Qwen4‑Max 在 Code Arena 前端盲测跻身全球前列;面向复杂专业任务的 Work360 基准拿到 52.69 分,高于上代 Qwen3.8‑Max 的 47.74 分。
Token 消耗优化非常可观:
- Work360:Xhigh / High 档位 Token 消耗分别降低约 24%、35%- Terminal‑Bench 4.0:Xhigh / High 档位 Token 消耗分别降低约 48%、49%
换算成账单,Work360 任务的单任务平均费用由 26.58 元降至 11.16 元,降幅 58%,在高频率、长流程的 Agent 场景下优势会持续放大。
落地实例:从工业到药物研发
官方放出一批偏向工程与科研的真实案例,凸显长程自主执行能力:
- 汽车加工编程:单个工件加工编程,人工耗时约 475 分钟,借助模型压缩至 24 分钟,人力投入削减约 95%;- 法律尽调:独立输出一份 86 页、六万余字的尽调报告;- 药物发现:在靶点筛选任务中,最终优选分子的结合亲和力达到初始分子的 3.6 倍;此外还有新材料筛选、芯片散热候选分子挖掘等科学计算案例。
在智能体交付上,Qwen4 还配套了 Live Delivery 机制:优先输出可使用的初版成果,再迭代打磨,配套插件对外放出,更贴合持续迭代的工程工作流。