浙大:自己不会把任务做好的模型可以当教师
Motivation
这篇论文研究一个反直觉问题:一个自己不会把任务做好的模型,能不能仍然成为优秀的教师?
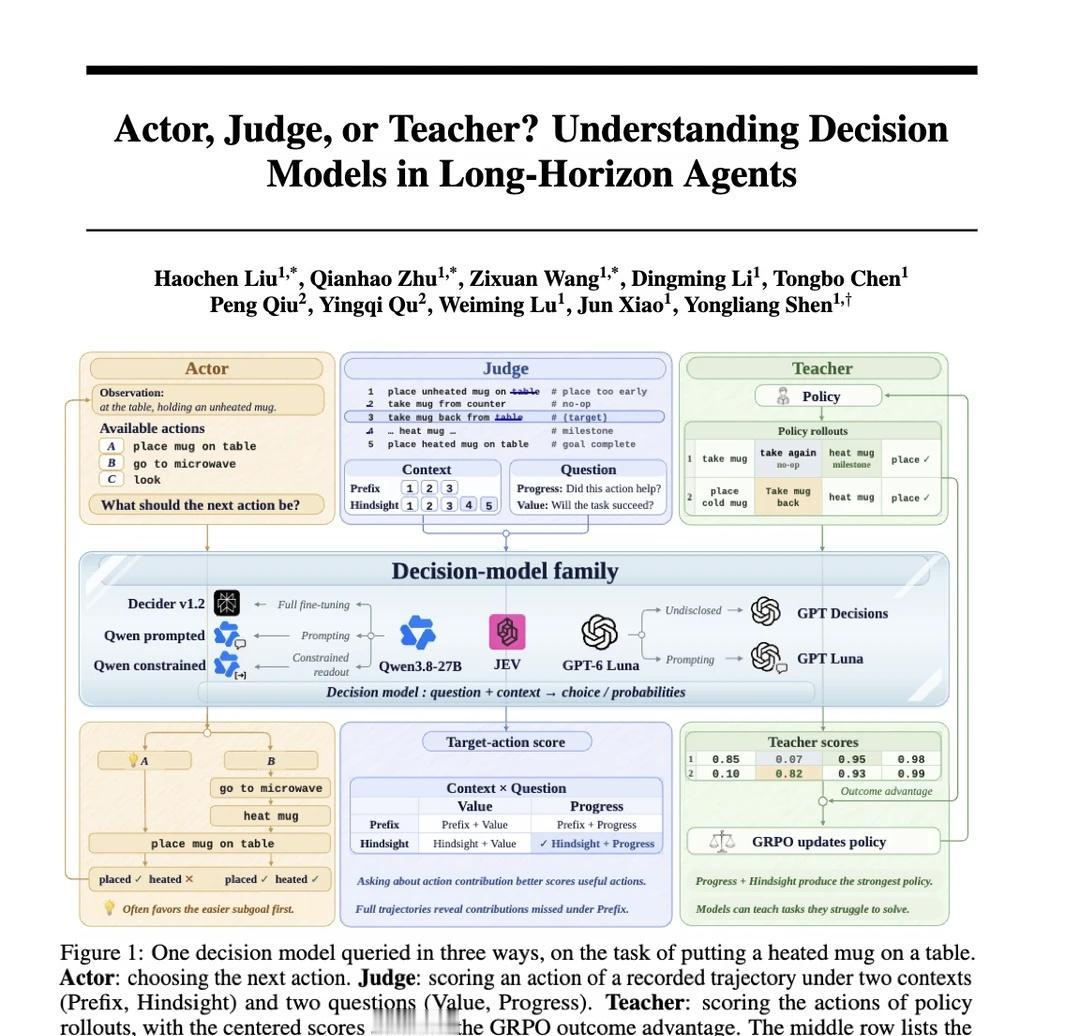
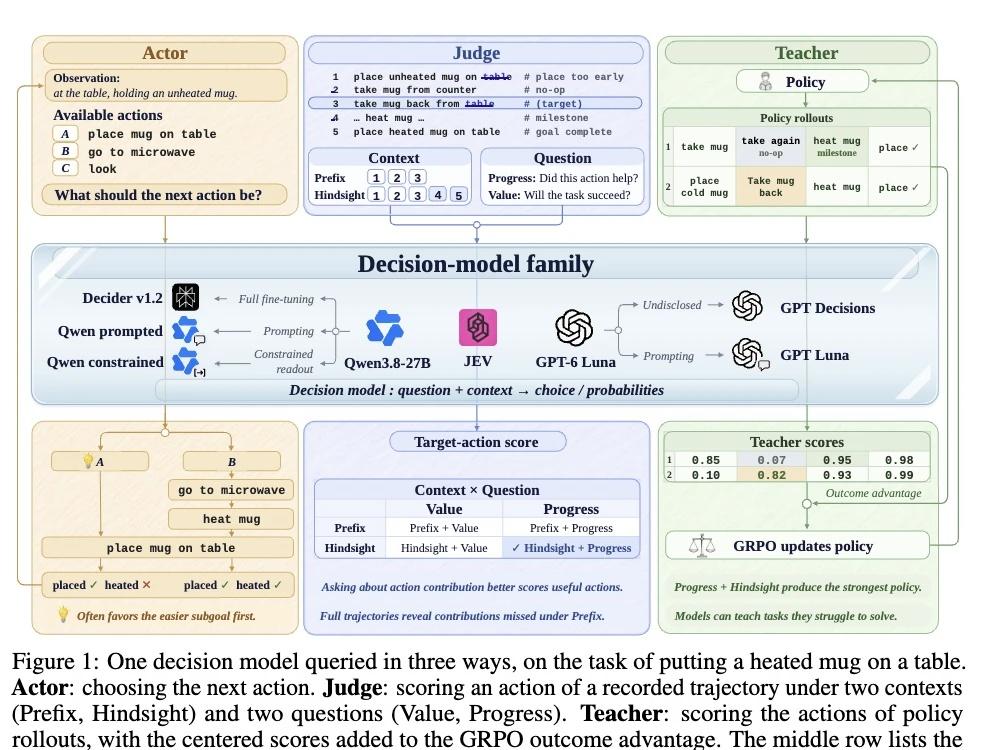
作者把同一类“决策模型”放进三个角色中比较:作为行动者时选择下一步动作;作为评审者时给已经执行过的动作打分;作为教师时,用这些步骤级分数指导另一个策略模型进行强化学习。此前研究主要根据“它自己能不能完成任务”评价决策模型,但论文指出,这可能严重低估其训练价值。
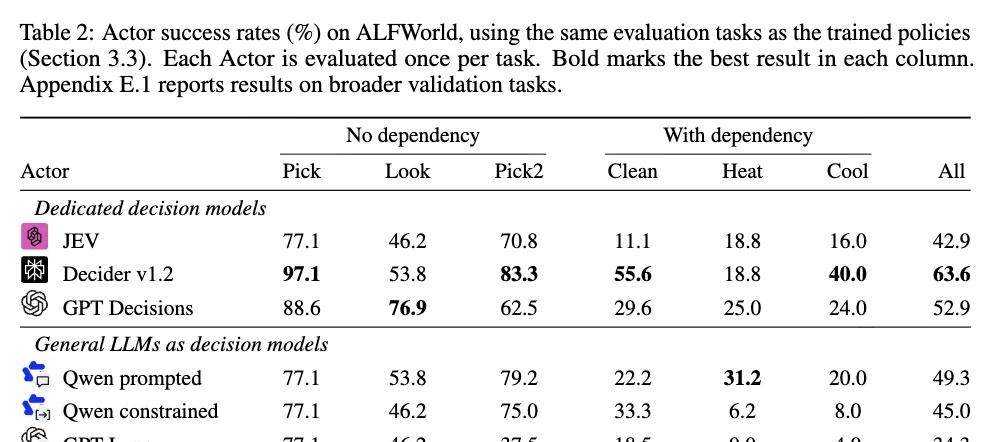
论文首先解释了为什么决策模型作为行动者会失败。ALFWorld中有些任务存在严格的子目标依赖,例如“把加热后的杯子放到桌上”,必须先加热,再放置。模型却容易被“立刻把杯子放到桌上”这种更简单、马上能完成的子目标吸引。JEV在两个互不依赖的子目标任务上成功率为70.8%,而在需要顺序的任务上只有约15%。
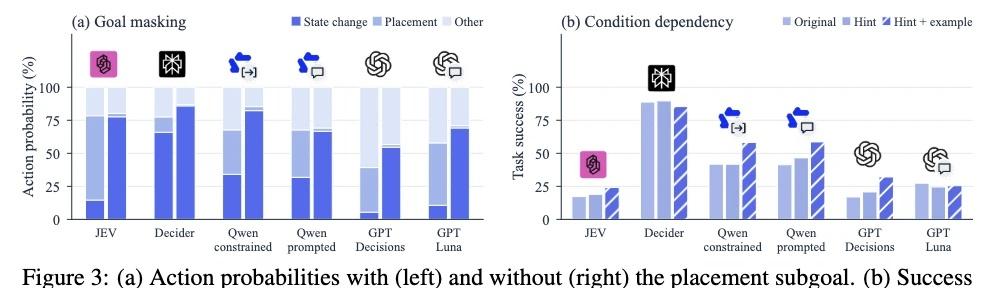
这并不是它不知道应该先加热。作者把“放到桌上”这个简单目标从任务中删掉后,JEV选择正确前置动作的概率从 14.6%直接升到77.6%。也就是说,问题更像是长程规划中的“短视”:模型知道正确步骤,却被眼前容易完成的目标吸引。
真正关键的发现发生在评审者角色。作者比较两个维度:一是只看当前步骤之前的历史,还是看到完整轨迹;二是问“任务会成功吗”,还是问“这个动作是否推进了目标”。
结果表明,完整轨迹提供了非常重要的事后信用分配信息。例如一个“打开微波炉”的动作在执行当下看起来没有直接完成目标,但当评审者看到后面“加热杯子→放置杯子”的过程后,才能确认它是必要的前置步骤。
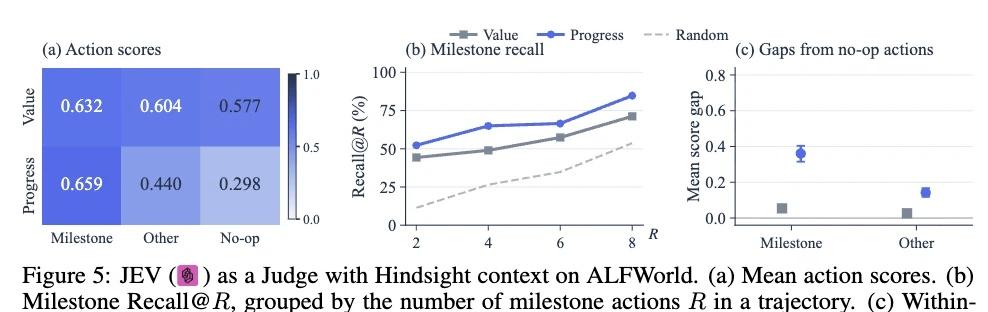
而“问什么”同样重要。如果问最终是否成功,同一成功轨迹里的所有动作都会得到相似高分;JEV对关键动作和无效动作的平均评分差只有0.05。改成问“这个动作是否帮助实现目标”后,关键动作与无效动作的差距扩大到 0.36,步骤级监督因此真正具有区分度。
结论:作者把这种评分加入GRPO的最终奖励中,让同一轨迹里的不同动作获得不同训练信号更有意思的是,提升最大的位置恰好是教师自己最不会做的任务。对于需要严格子目标顺序的任务,训练后的策略成功率达到 86.8%,而JEV自己作为行动者只有14.7%左右。这说明监督模型不一定需要拥有比学生更强的行动能力。行动要求预测未来后果,而事后评价可以直接看到这些后果。 信息条件不同,使“弱行动者→强教师”成为可能。
jev 大模型 LLM 智能体 agent 机器学习 强化学习 harness RL