刚刚,DeepSeek 把 App 里那一整套能力做成了 API,开放给所有开发者。
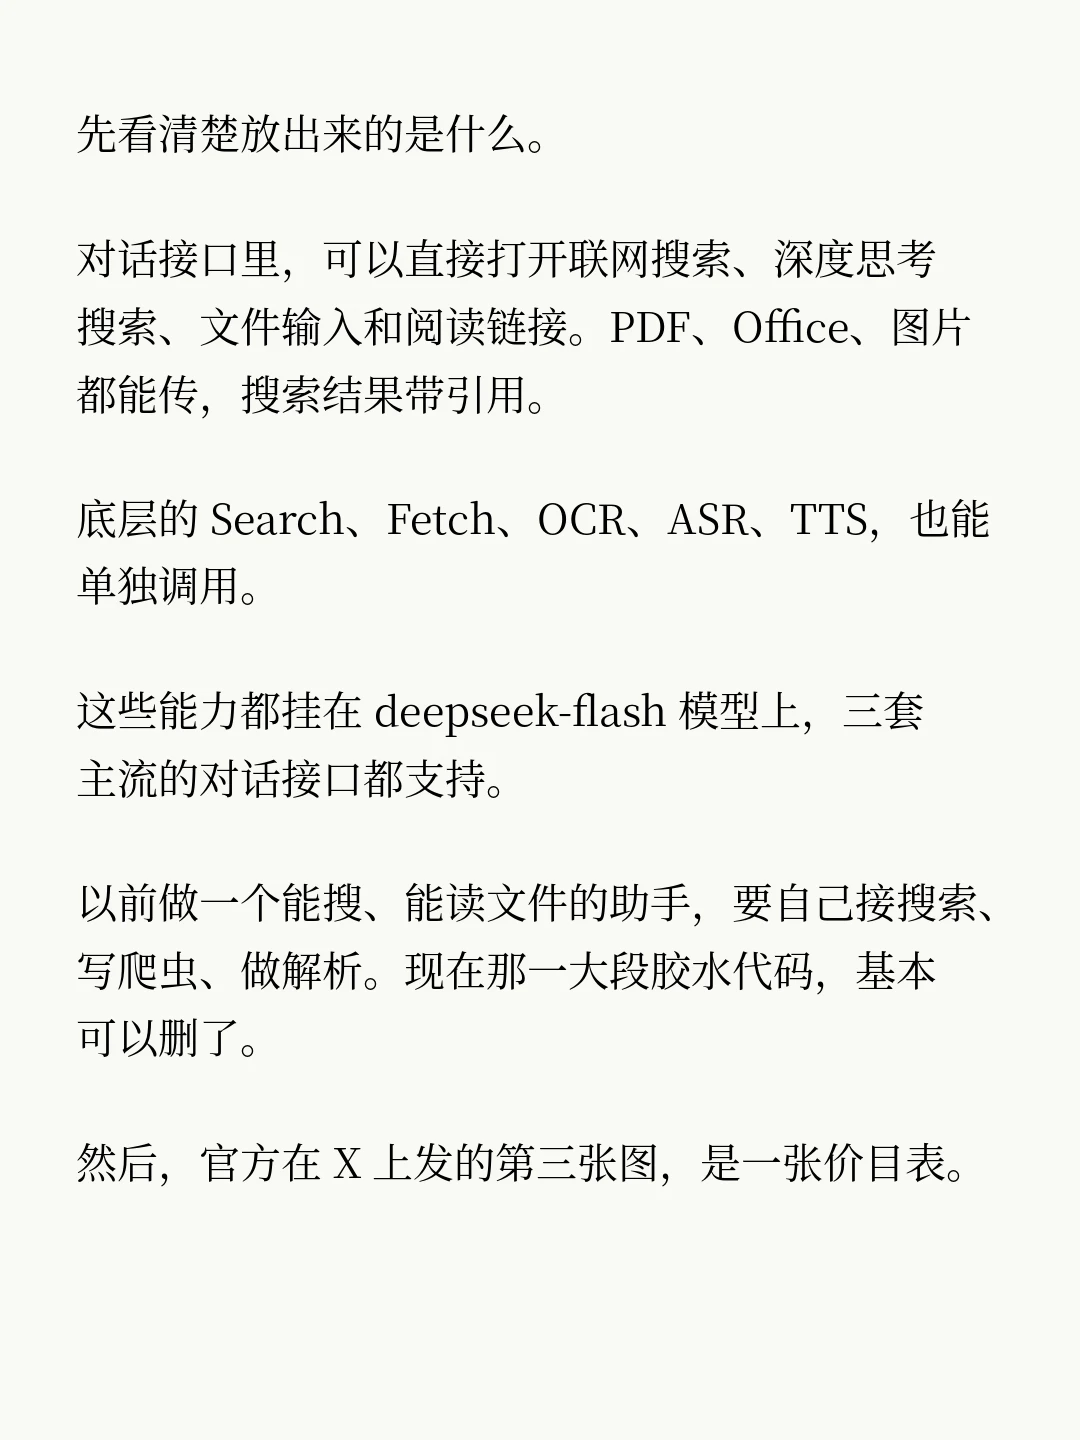
联网搜索、深度思考搜索、文件输入(PDF、Office、图片)、阅读链接、安全校验,在对话接口里开个参数就能用。工具调用和上下文拼接,也都交给服务端处理。
底层的 Search、Fetch、OCR、ASR、TTS 也能单独调用。官方还开源了一个演示用的对话客户端,能导入你在 DeepSeek 的历史对话。
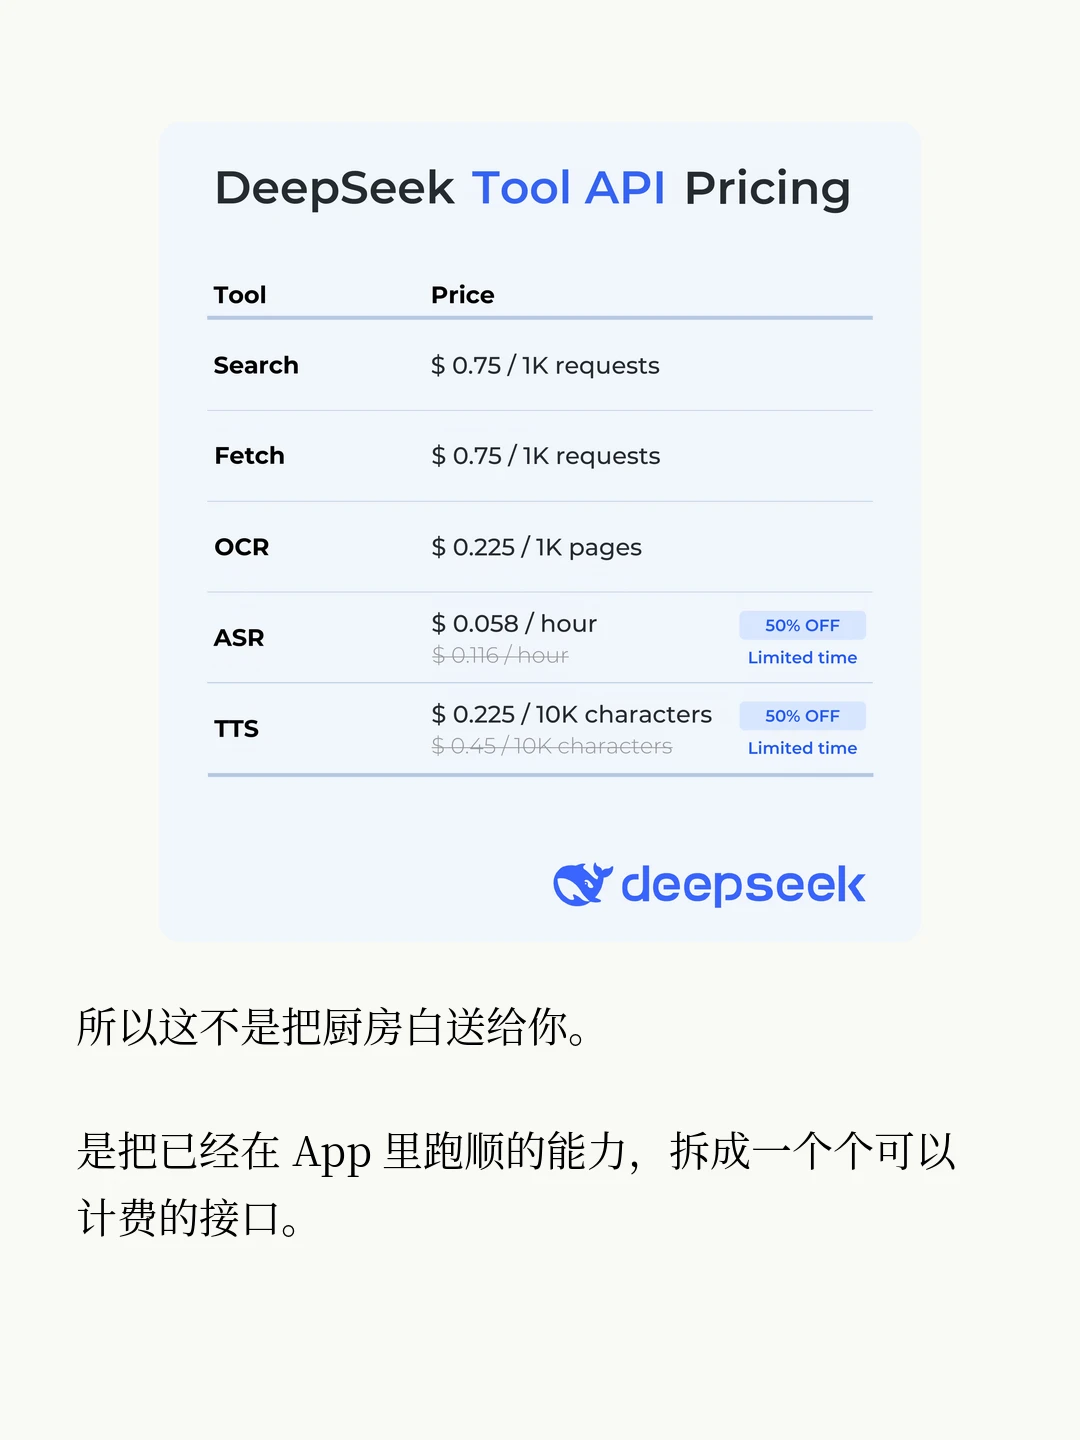
先说我的判断:这当然不是白送,是把 App 里已经跑顺的能力,拆成一个个可以单独调用、单独计费的接口。
这也跟他们一贯的成本控制有关。10 月 20 日 DeepSeek 把自家生产级推理框架 DeepInfer 开源了,还把线上推理的吞吐和成本数据一并公开了。
一个集群每天能处理多少请求、单卡能跑出怎样的效率,都写在部署实践里。
能把全家桶铺到这个程度,前提往往是自己先把推理成本压下去。没有这一层,后面那些搜索、语音、文件解析,很难按现在这个量级放开。
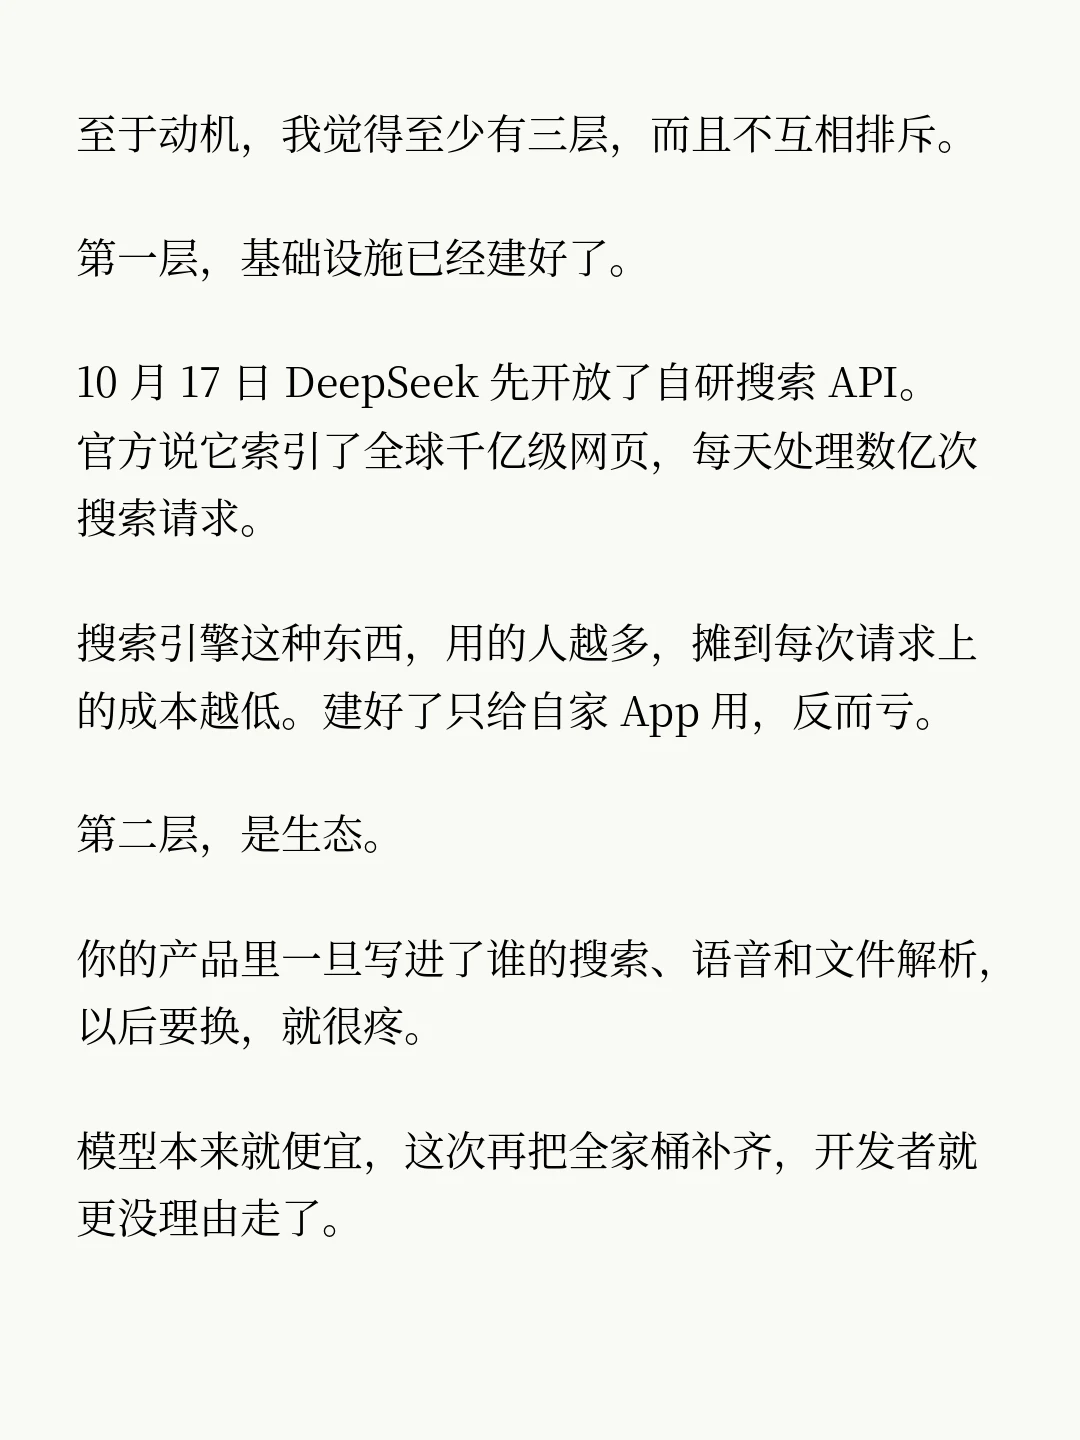
关于动机,我觉得至少有三层。
第一,基础设施已经建好了。10 月 17 日 DeepSeek 先开放了自研搜索 API,索引了千亿级网页,每天处理数亿次搜索。这种东西用的人越多,摊到每次请求上的成本越低。
第二,是生态。你的产品里一旦接了谁的搜索、语音和文件解析,以后要换就很疼。
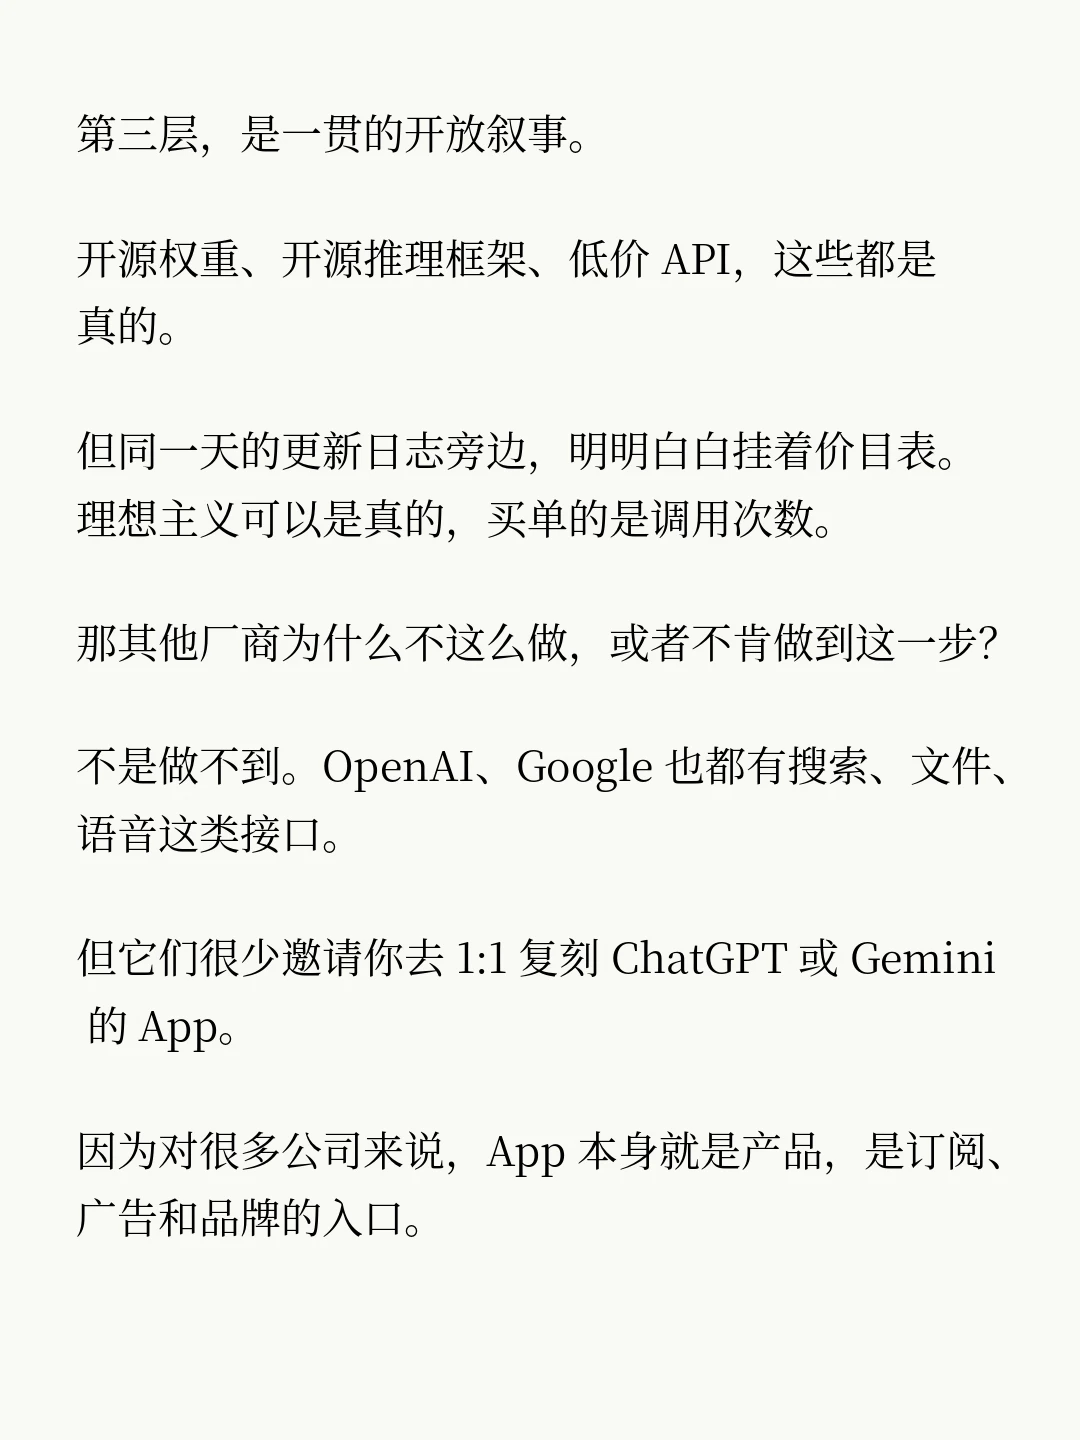
第三,是开放叙事。开源权重、开源推理框架、便宜的调用方式都是真的,但计费规则也同样真实。
别家为什么不这么做?
不是技术上做不到。OpenAI、Google 也有搜索、文件、语音这类接口,但很少有人邀请你 1:1 复刻自家 App。
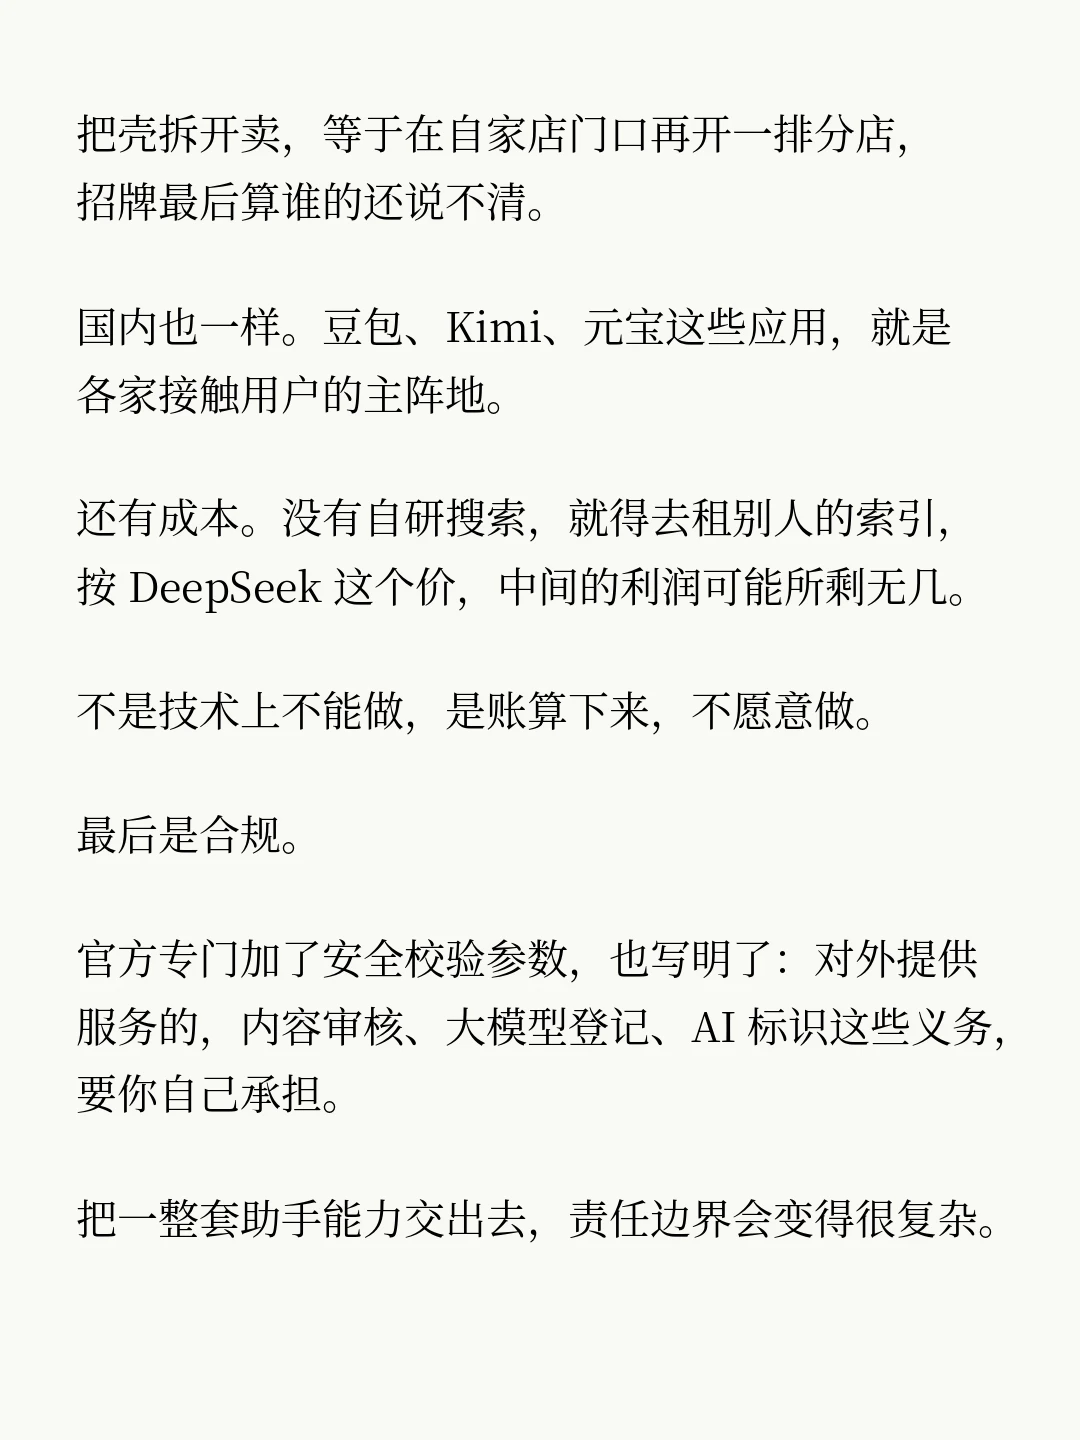
对它们来说,App 本身就是产品,是订阅和品牌的入口,是各家接触用户的主阵地。
还有成本。
没有自研搜索,就得去接别人的索引,中间可能剩不下多少空间。
DeepSeek 文档里也写明了:对外提供服务的话,大模型登记、AI 标识,都要开发者自己负责。
我的看法是:理想的成分也许有,但今天这一步,更像是把建好的基础设施,变成别人离不开的能力。
做 AI 应用的朋友,值得去翻一下 DeepSeek 这套全家桶了。
#DeepSeek #howto用AI手搓APP #AI #大模型 #开发者 #人工智能 #AI打工人