真的想不通,为啥差距这么大?
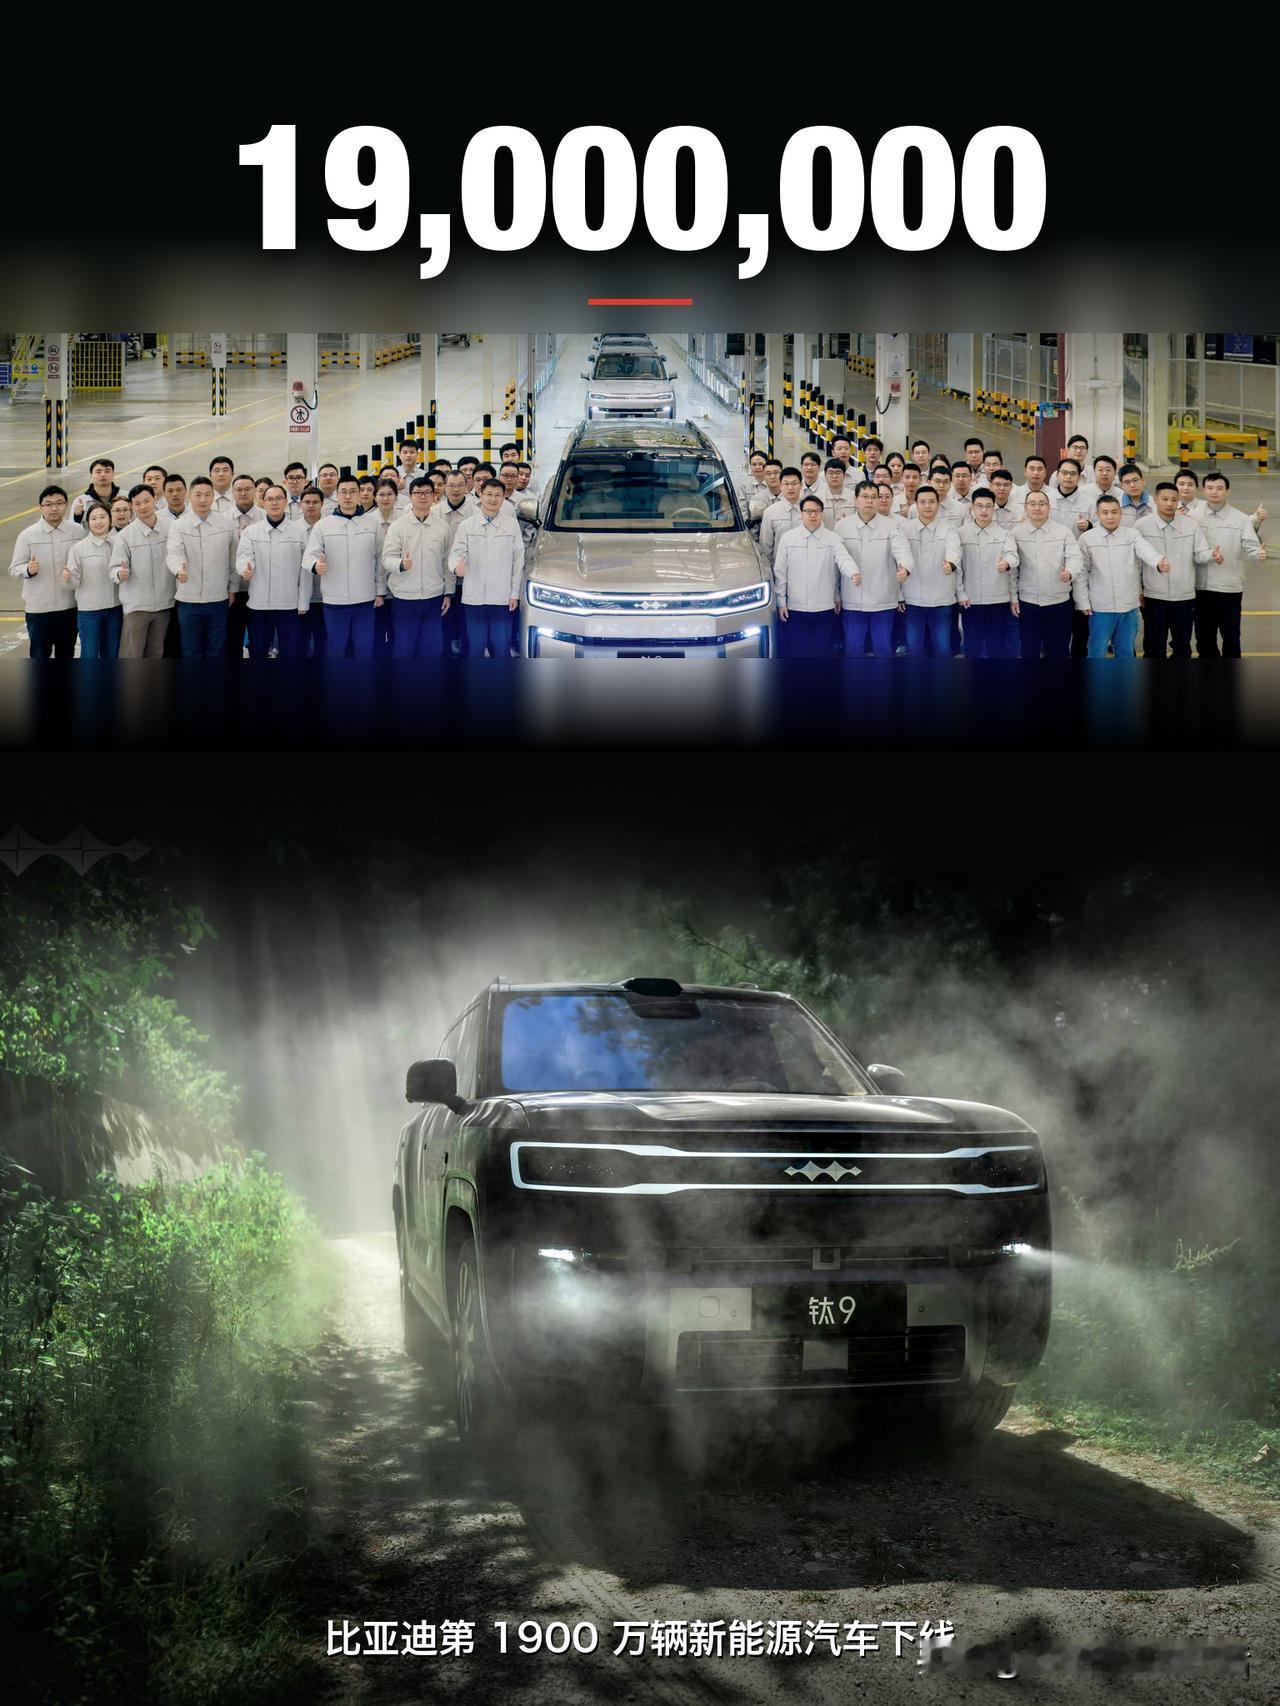
图1 用 WorkBuddy+DeepSeek,14 分钟
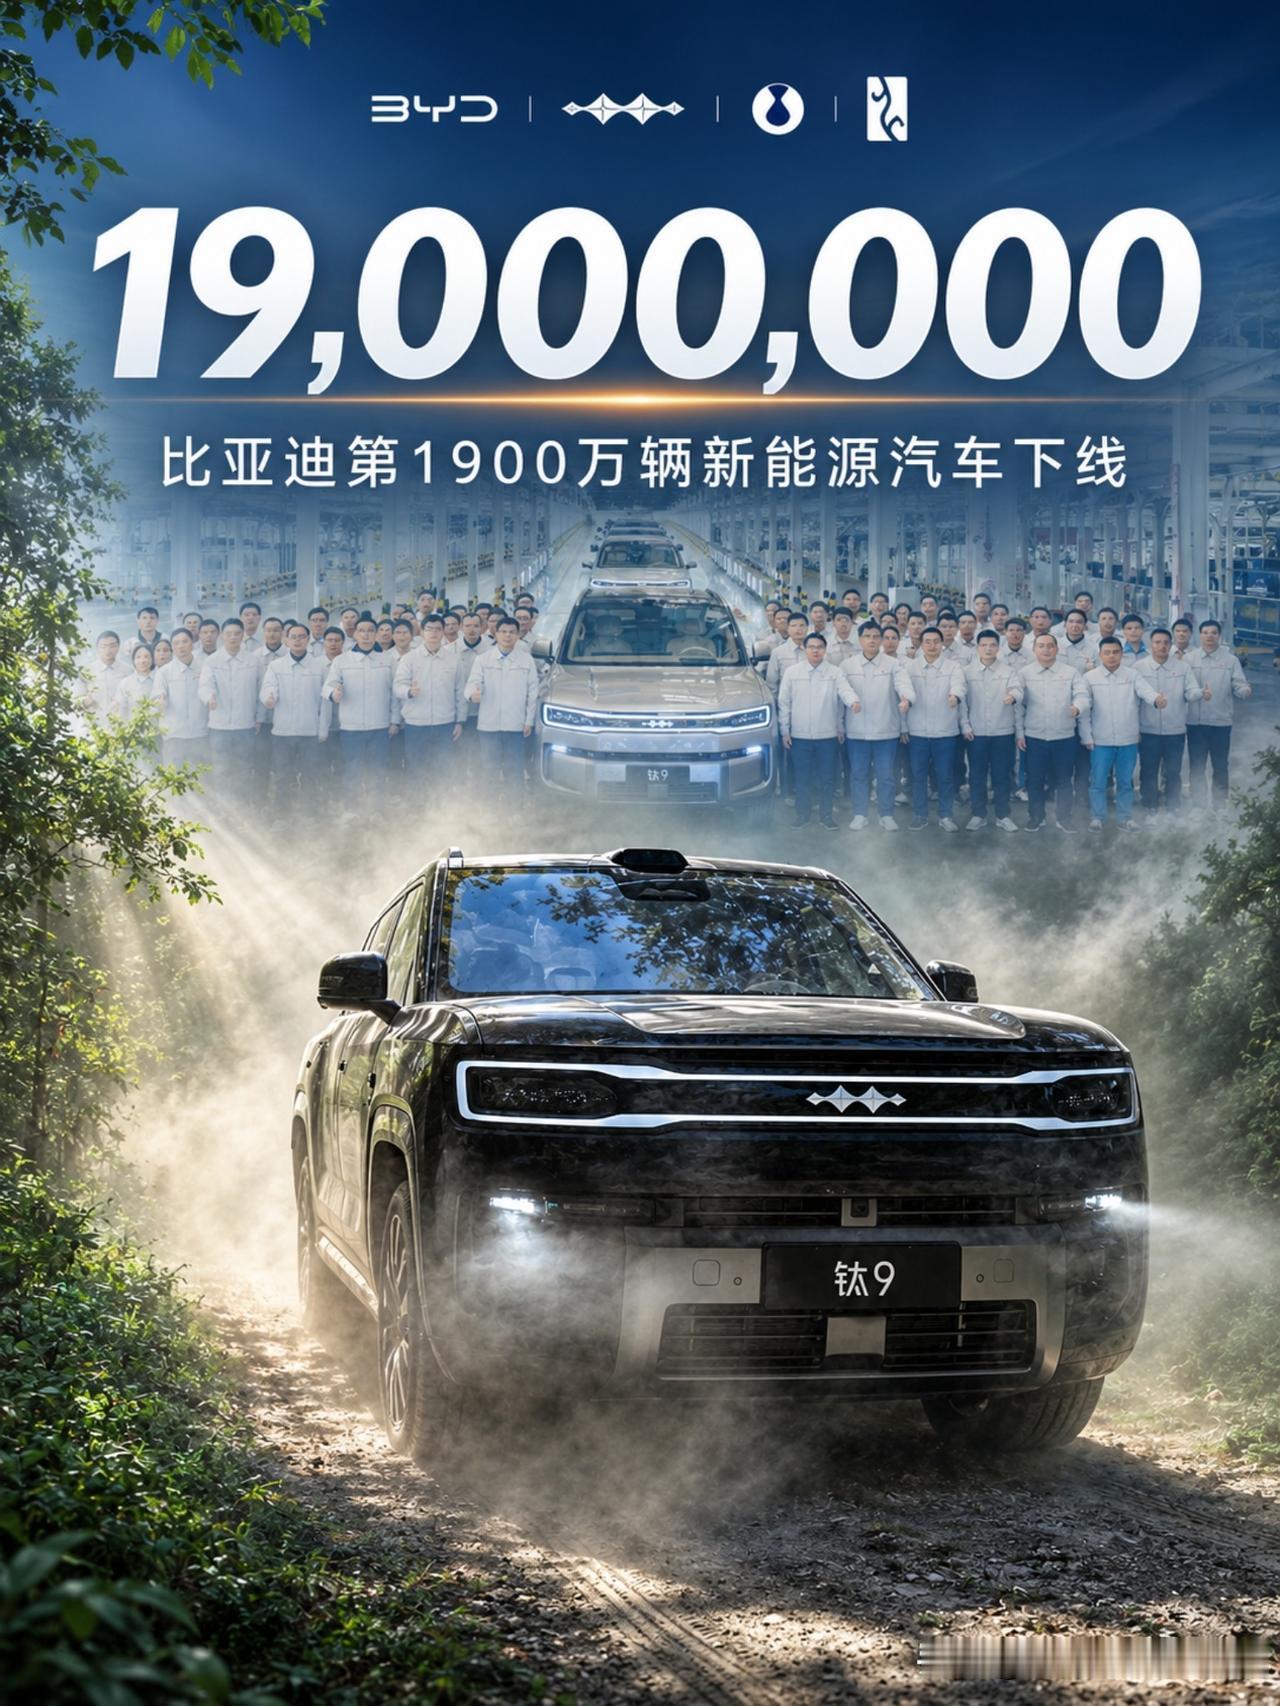
图2 用 ChatGPT,1 分钟就完事
我他们两个的指令都是把这两张图合成一张 3 比 4 的,中间用渐变蒙版过渡。上面大字写 19000000,能加千分号就加上。
结果图1,Workbuddy产出的图看着就糙。上面一块黑的,中间一张工厂的合影,下面一辆车,三块直接摞在一起,接缝线特别生硬。
图2 完全是另一回事,雾把上下连成了一片,工厂那张退到后头,车在前头,看着像一张照片拍出来的。我把图2 放大看,人的影子落在地上,车底下压着碎石,都对得上。
两张摆一块儿,我感觉差了一个级别。图1 像机器粗糙拼出来的,图2 像设计人员专门做的,这不是我第一次觉得ChatGPT做的图好了,难道它真的遥遥领先咱们国产模型吗?
为此我专门查了一下。 DeepSeek v4.1 Flash模型能理解图片,你把图发给它,它能说出图里有什么。可它回给你的只有字,出不了图,也就是说它不能画图,它执行指令本质是写代码。
所以我又把 WorkBuddy 的模型列表翻了一遍,五个全是聊天的,混元、GLM、Kimi、MiniMax、DeepSeek,没一个是管画图的。
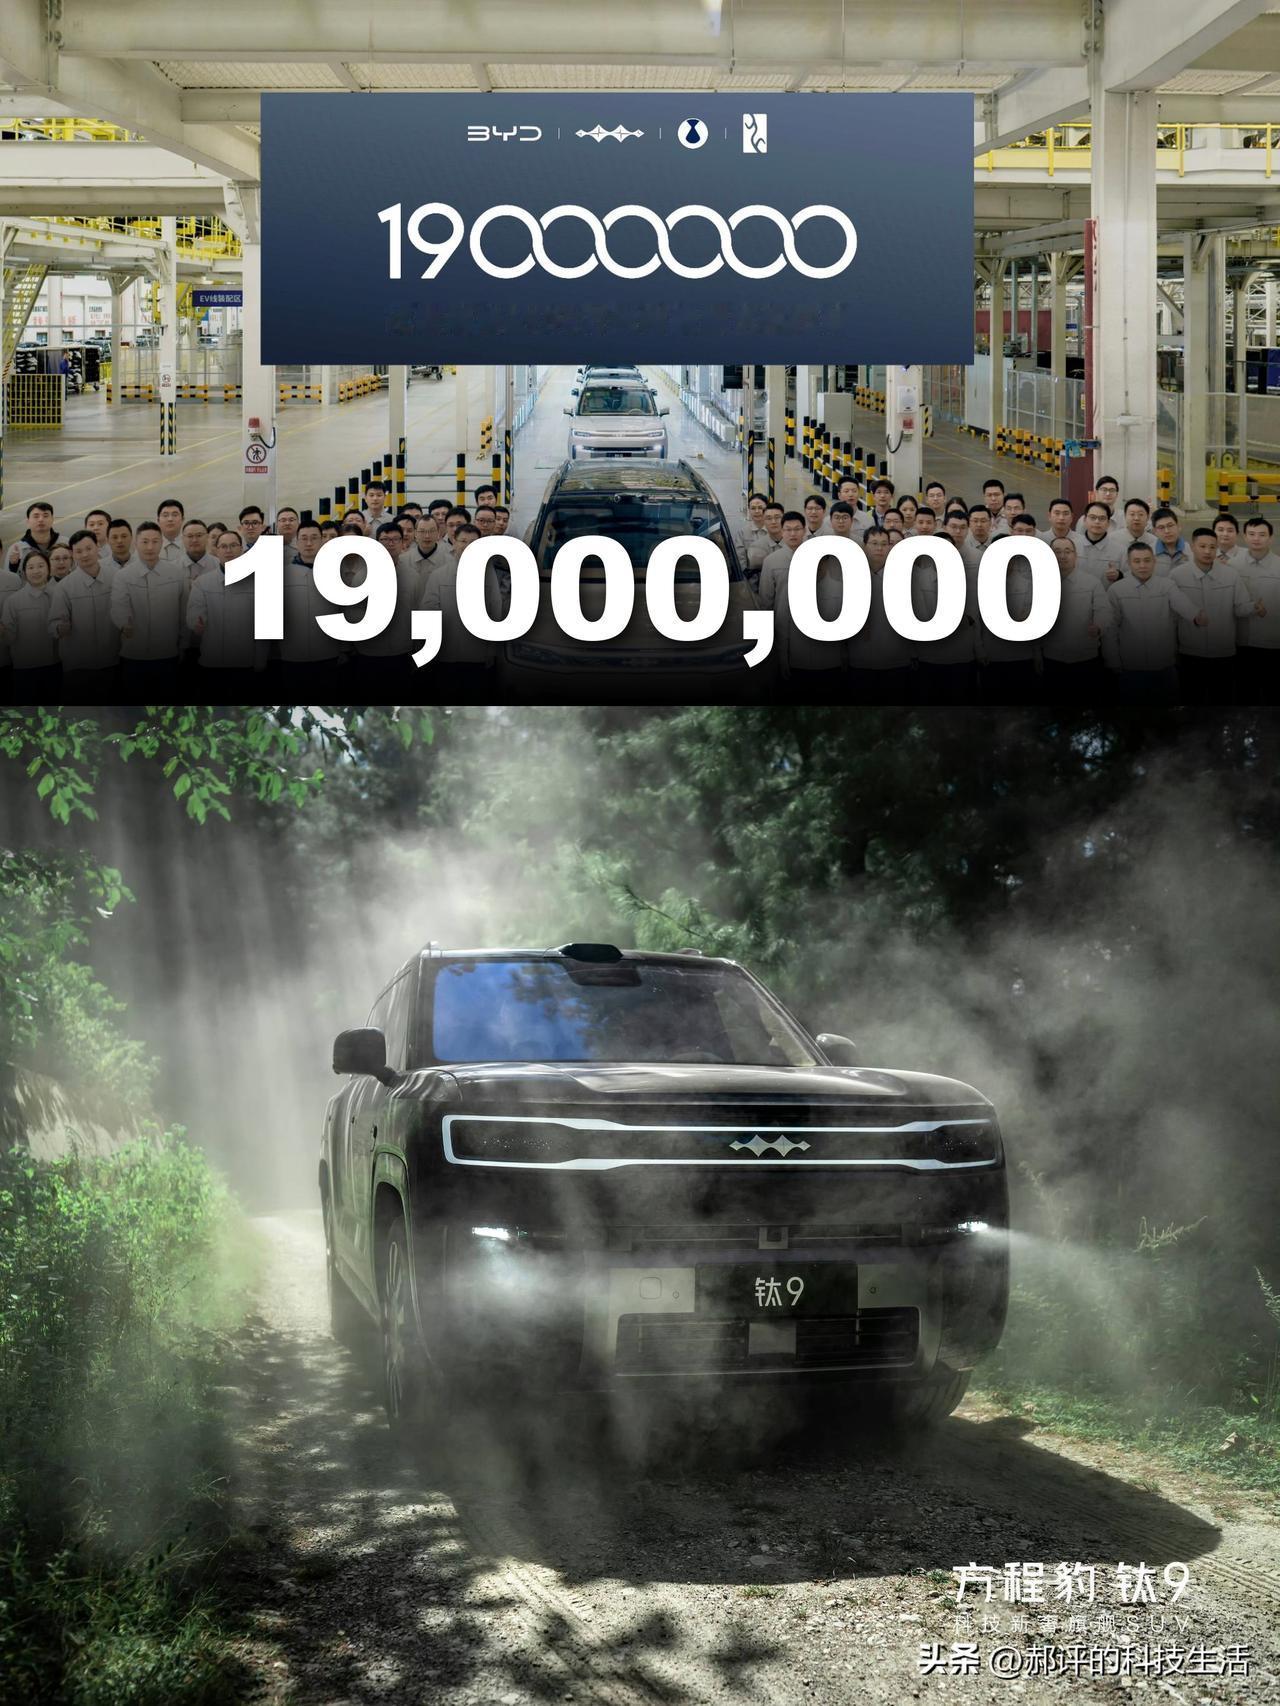
那就不折腾模型了,我直接切到WorkBuddy里面的设计模式,调成快速模式,15 分钟图出来了,如图三3,结果还是一样糟糕,拼贴感依旧明显,很不自然。
说实话,折腾了一个多小时,我感觉ChatGPT在你说话的时候它就在画,听懂和画是同一个模型干的,理解的准,也画的准,所以渐变蒙版、字放上面这种话它能照着做,光从哪来,雾怎么散开,人和车怎么放进一个空间,它自己都能算明白,而且速度很快。
Workbuddy用了半年多吧,ChatGPT也陆陆续续用了小一年,我的主观感觉越来越明显,就是ChatGPT的图片处理能力真的断档领先。
不知道你们平时做封面、做海报都用哪个模型?难道国产通用模型里面真的没一个能和 ChatGPT抗衡的吗?