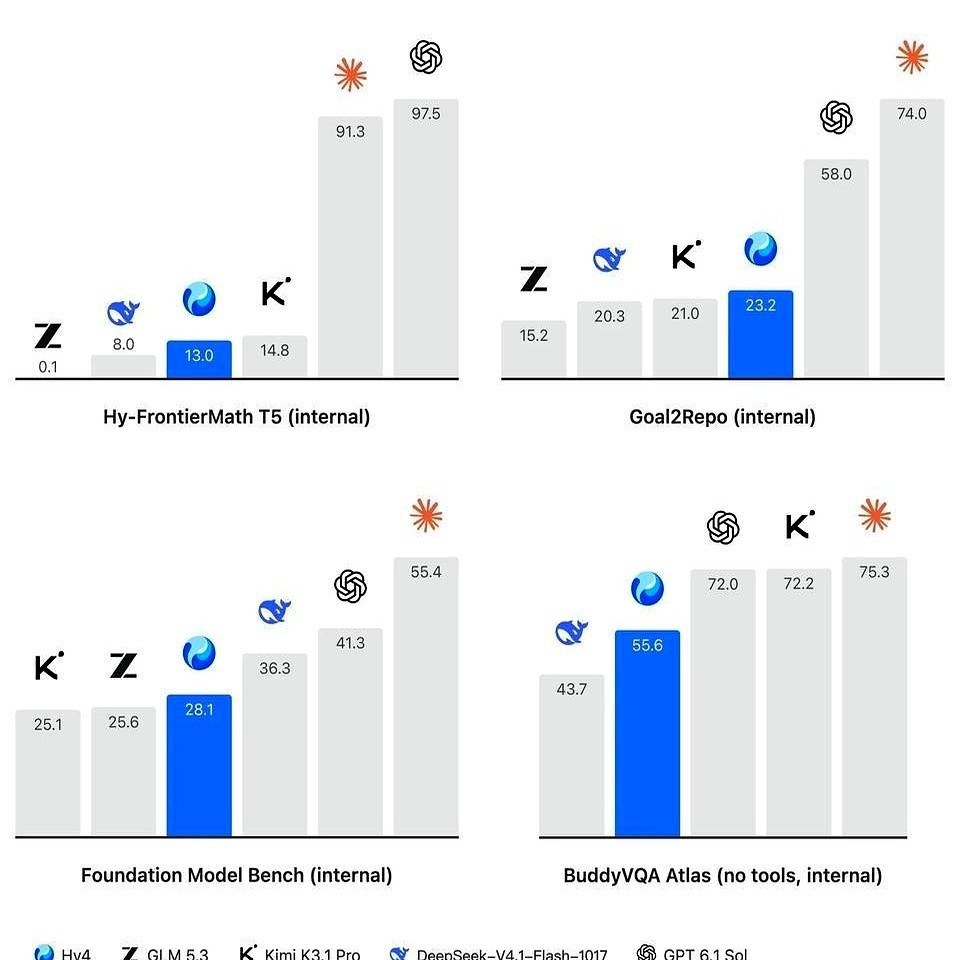
腾讯混元最新公布的一张大模型内部实测图,把科技圈遮遮掩掩的一层窗户纸,当众扯了下来。
在难度极高的前沿科研推演测试里,海外两款最顶尖的模型一路飙到了九十分开外,而国内几款主力选手最高的一档只在十来分打转,有的甚至直接贴着地皮,连一分都没拿到。
整张测试图干干净净列着四场硬仗,没有添加任何视觉滤镜。
大家早习惯了发布会上精心挑选的战报,挑几个赢面做几张好看的幻灯片,把落后的指标塞进没人看的附录里。
可这次呈现在白纸黑字上的数据,却横着一条刺眼的断层:
在直接构建完整代码库的考核中,海外顶尖选手稳稳拿下五十分到七十分的高分,国内冲在最前面的模型还在二十出头的区间摸索;
到了基础综合基准测试,海外模型依然压在四十到五十分,国内主力则大多在二三十的分数线上徘徊。
唯一咬得极紧的战场是图文多模态问答。国内头部选手几乎贴身肉搏,双双拿下了七十分以上的好成绩,把距离缩短到了半个身位。
优缺点摆得明明白白,底牌彻底翻开。
在日常办公、应用落地和产品打磨上,国内的技术迭代快得惊人;可一旦撞上深度符号运算、极长逻辑链推演这种学术硬骨头,顶级实验室多年积累的底座深度,依然是一道绕不过去的坎。
能把自家的软肋清清楚楚画出来亮给全行业看,需要极大的底气。
比起做几张宣布大获全胜的宣传画,这种把差距摊在阳光下的坦诚,你觉得是清醒的长跑姿态,还是多虑了?