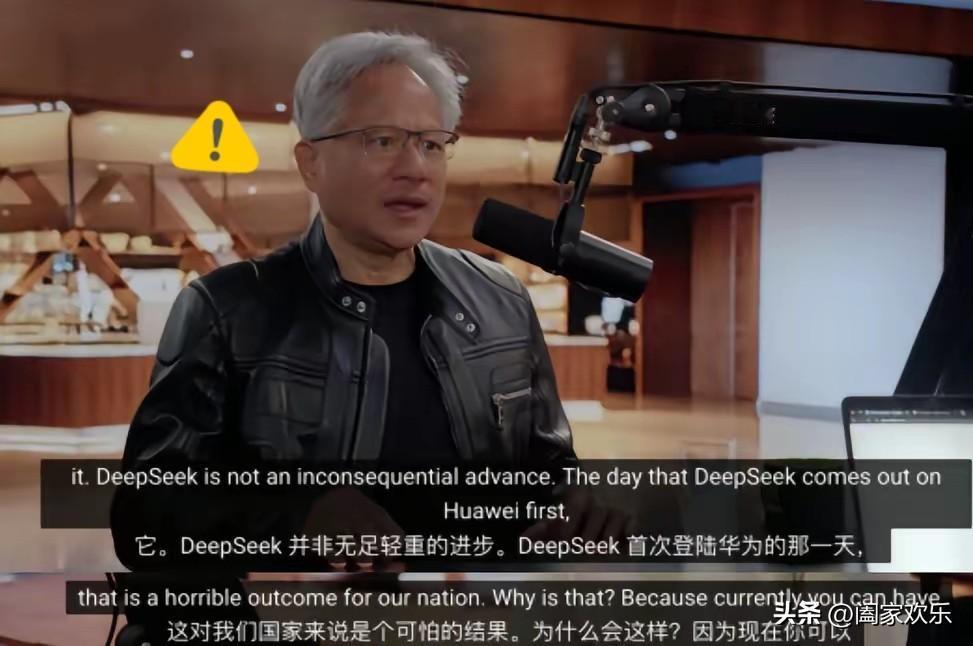
现在来看,黄仁勋之前作出的预测,十有八九是对的。
黄仁勋此前说DeepSeek首次跑在华为芯片上,对美国是个可怕的结果。当时都以为他在帮英伟达要政策。现在看,他是认真的。DeepSeek选华为,不是退而求其次,是强强联手。
4月17日那场播客采访里,黄仁勋真急了。主持人拿“卖芯片给中国就像送浓缩铀”这种话堵他,他直接回怼“芯片又不是浓缩铀”。但真正让他破防的,是另一句话——“如果DeepSeek这种顶尖模型以后首发跑在华为芯片上,对美国来说就是可怕的结果”。七天后,这句话成真了。
4月24日,DeepSeek V4发布,打破了行业惯例。以往大模型都会优先给英伟达提供早期访问权限做优化,这次DeepSeek把优先期给了华为。底层代码从依赖CUDA重写为华为CANN框架,在昇腾950超节点上,V4-Pro的单token解码时延做到约20毫秒,V4-Flash更是压到了10毫秒。这延迟水平,放在全球范围也是第一梯队的。
黄仁勋怕的到底是什么?他在访谈里被追问时露了底——“假设它是针对华为优化的,针对他们的架构化了,那就会让我们处于劣势”。英伟达的护城河从来不是GPU算力本身,是CUDA。过去二十年,所有主流AI模型的首发优化都以CUDA为默认起点,形成了一条“越多人优化CUDA,CUDA上跑得越好”的自我强化链条。DeepSeek在昇腾上首发,等于在这条链条的起点上凿了一个洞。
性能数据摆在那儿。昇腾910C采用中芯国际7nm工艺,530亿晶体管,DeepSeek团队实测推理性能达到英伟达H100的60%。单看这个数字,确实还有差距。但华为走的不是单卡硬拼的路线,昇腾950超节点在8K输入场景下,V4-Pro单卡解码吞吐能做到4700 TPS。用系统工程层面的群体战术去弥补单卡差距,这才是让黄仁勋真正焦虑的地方。
英伟达在中国市场的处境也在印证这个判断。黄仁勋自己承认,英伟达在中国AI加速器市场的份额已经降到了0%,两年前这个数字还是80%以上。Bernstein预测,2026年华为在中国AI芯片市场的份额将升至50%。这不是某款芯片被替代的问题,是整个生态位在被蚕食。
更深层的意义在于,DeepSeek证明了一条真实可运行的非CUDA路径是走得通的。CANN生态上会沉淀下熟练的工程师、可复制的优化经验、以及第一批用户信心。一旦这条路被打通,后来者不需要从零摸索,迁移成本会大幅下降。对全球AI开发者来说,“必须用CUDA”这条默认规则,第一次有了公开的反例。
黄仁勋说那句话的时候,很多人以为他在帮英伟达要政策、要出口许可。现在回头看,他是真看到了危险。一个中国最顶尖的大模型,至少在推理端,已经可以不必完全依赖英伟达的卡了。芯片封锁想卡住的那条命脉,正在被一条一条地绕过去。
各位读者你们怎么看?欢迎在评论区讨论。