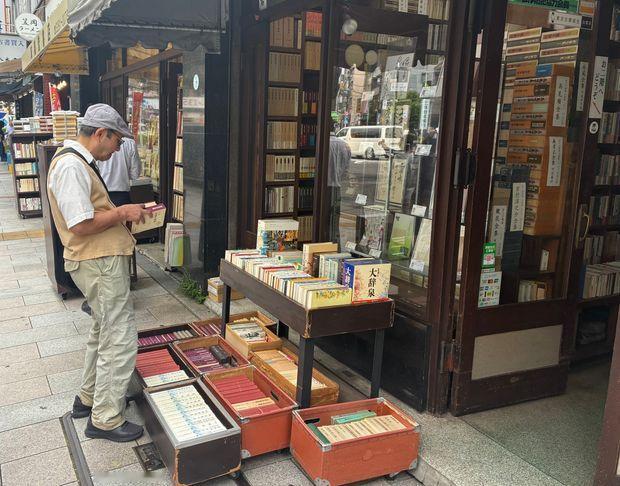
“大模型不聊天了,开始‘吃纸’了!” 据日本古书界爆料,日本多地突现大批神秘买家,扫货式狂买二手书——历史、哲学、医学、法律,连偏远地方志、几十年前政治小册子都照单全收。有古书店一天卖上百本,单店成交破千。更瘆人的是:下单账号五花八门,所有包裹却全发往同一个跨境物流中转站。这不是淘书,这是文献清剿?背后到底是谁在操控——大模型,还是更可怕的局?
日本电视台顺着贸易记录往下查,扒出来的数字让人倒吸一口凉气。据日本电视台9月21日报道,从去年开始,超过50吨日本二手书籍被出口到了美国,报关品名写得明明白白:JAPANESE BOOKS。
50吨什么概念?一本旧书按500克算,那就是整整10万册纸质书被打包塞进集装箱运出了国门。
东京神田神保町是全世界出了名的古书店街,那里的店主们最开始还以为来了大客户。
结果一看订单就傻眼了。不挑作者,不看品相,不计较版本,哲学、历史、医学、法律,连江户时代的生活文化、三十年前政界旧事这类冷门书都照单全收。
有店主说,订单间隔几乎是固定的,感觉像是机器在自动下单,正常买家哪会这么干。那这些书到底买去干嘛?答案指向一个方向:拆了扫,扫了喂AI。
据朝日新闻9月18日报道,日本书籍出版协会已经向日贩集团发出书面文件,要求说明是否向美国AI企业Anthropic大量售书,以及是否包含协会成员出版社的出版物。日贩的回应是:对个别交易内容不予回答,但表示没有以AI学习用途为前提进行过销售。
说到这事儿,就绕不开Anthropic这家公司。Claude大模型就是他们搞的。根据《华盛顿邮报》依据法庭解封文件所作的报道,Anthropic内部有个项目叫“巴拿马计划”,内部文件写得很直白:这是他们对世界上所有图书进行破坏性扫描的努力。
具体怎么操作呢?批量买二手书,用液压切割机把书脊切掉,送进工业级高速扫描仪逐页扫描,数字化完成之后,原书直接进碎纸机打成纸浆。
一本书的物理形态彻底没了,只剩下文字数据被喂进模型里。据报道,Anthropic为这个项目投入了数千万美元,采购规模达到数百万本。
去年6月,美国加州北区联邦法官William Alsup作出判决,认定Anthropic将合法购买的纸质书进行数字化扫描用于训练,属于合理使用。
但在另一起诉讼中,这家公司因为在盗版网站下载了大量电子书用于训练,最终同意支付15亿美元和解金,涉及约50万部作品,平均每本赔偿约3000美元。
那硅谷这帮人为什么突然对旧书这么饥渴?原因就一个:互联网上的东西被吃干净了。过去几年,大模型把全球网页上的公开文本基本爬了个遍。
维基百科、论坛、新闻网站、社交平台,能吃的全吃了。据Epoch AI的研究预测,如果当前开发趋势持续,模型训练将在2026年到2032年间耗尽互联网上可供使用的公开人类文本数据。
更麻烦的是,网上剩下的东西已经不能吃了。SEO公司Ahrefs在2025年4月分析了90万个新建英文网页,发现74.2%含AI生成内容。
AI代码审查公司Graphite的数据则显示,2024年11月AI生成文章数量首次超过人类撰写的文章。如果大模型继续吃这些AI自己生产的内容,就会陷入“模型塌陷”。
《自然》杂志发表的论文已经证实了这一点:让AI用AI生成的数据来训练自己,模型输出会逐渐失去多样性,最终沦为单调的模式复制。
所以2022年之前出版的纸质书,就成了眼下唯一干净的“粮源”。这些书没有被AI污染过,没有被算法改写过的逻辑,里面是纯粹的人类思考和记录。
日本偏偏就是这块“干净粮源”里最厚的一块。日本孤悬海外,过去一千多年避开了大量战火,保存了东亚地区大量的古籍文献。
从江户时代的“兰学”翻译,到明治维新后大规模译介西方文献,积累下来的纸质文献数量惊人。这些书排版规整、纸张优良、文字识别率极高,对AI公司来说就是高纯度的训练数据集。
日本书籍出版协会的态度很明确:反对将书籍用于AI学习目的,已经要求经销商不要出售任何新书用于AI训练。
有些出版社已经开始在版权页印上禁止将本书内容用于人工智能训练的声明。态度是好的,但实操层面基本拦不住谁。AI模型是个黑箱,你根本没法查证某本书是否被训练过。
神保町的书架正在变空。那积累了上百年的旧纸,被一批批运走,不会再流回来。从二手书店的异常订单,到跨境的50吨书籍出口,再到硅谷的批量扫描销毁,一条围绕纸质书的隐秘链条已经浮出水面。而链条的终点,是AI公司对“干净数据”近乎饥渴的需求。